· 技術革新とデジタルトレンド · シリーズ: テクノロジーの現在地 · 読了目安 15 分
AIクローンをRAGで作ると「他人の意見」まで本人の思想になる問題と、その設計上の解決策
自分が過去に書いたブログ、SNS、日記、チャット、メールなどをAIに読み込ませ、「自分AI」や「AIクローン」を作る。
生成AIとRAGが身近になったことで、以前なら研究テーマだったようなことを、個人でも試せるようになってきた。
過去の記録が十分にあれば、
「私は以前、このテーマについて何と書いていたか」
「この問題について、自分はどう考えてきたか」
といった問いには、かなり面白い回答が返ってくる。
しかし、実際に作ろうとすると厄介な問題がある。
自分の記録の中には、自分以外の人の意見も大量に含まれている。
Facebookのコメント欄、Slackの議論、メールへの返信、インタビュー、引用、議事録。
それらを全部RAGに入れると、AIは「そこに書かれている内容」を検索できるようになる。
しかし、
その発言を誰がしたのか。
本人はそれに賛成したのか。
単に理解を示しただけなのか。
条件付きで賛成したのか。
その考えを今でも持っているのか。
ということは、単純な類似検索だけでは十分に表現できない。
すると、他人の意見まで本人の思想としてAIクローンが語り始める。
これは検索精度とは少し違う問題である。
この記事では、この問題を三つの例から考え、最後に、AIクローン向けのデータモデルとして
Speaker Attribution
+ Stance
+ Commitment
+ Condition
+ Temporal Versioning
を持たせる方法を提案する。
1. 最初の事故。「それ、Aさんの意見です」
まず、極端に簡単な例を考えてみる。
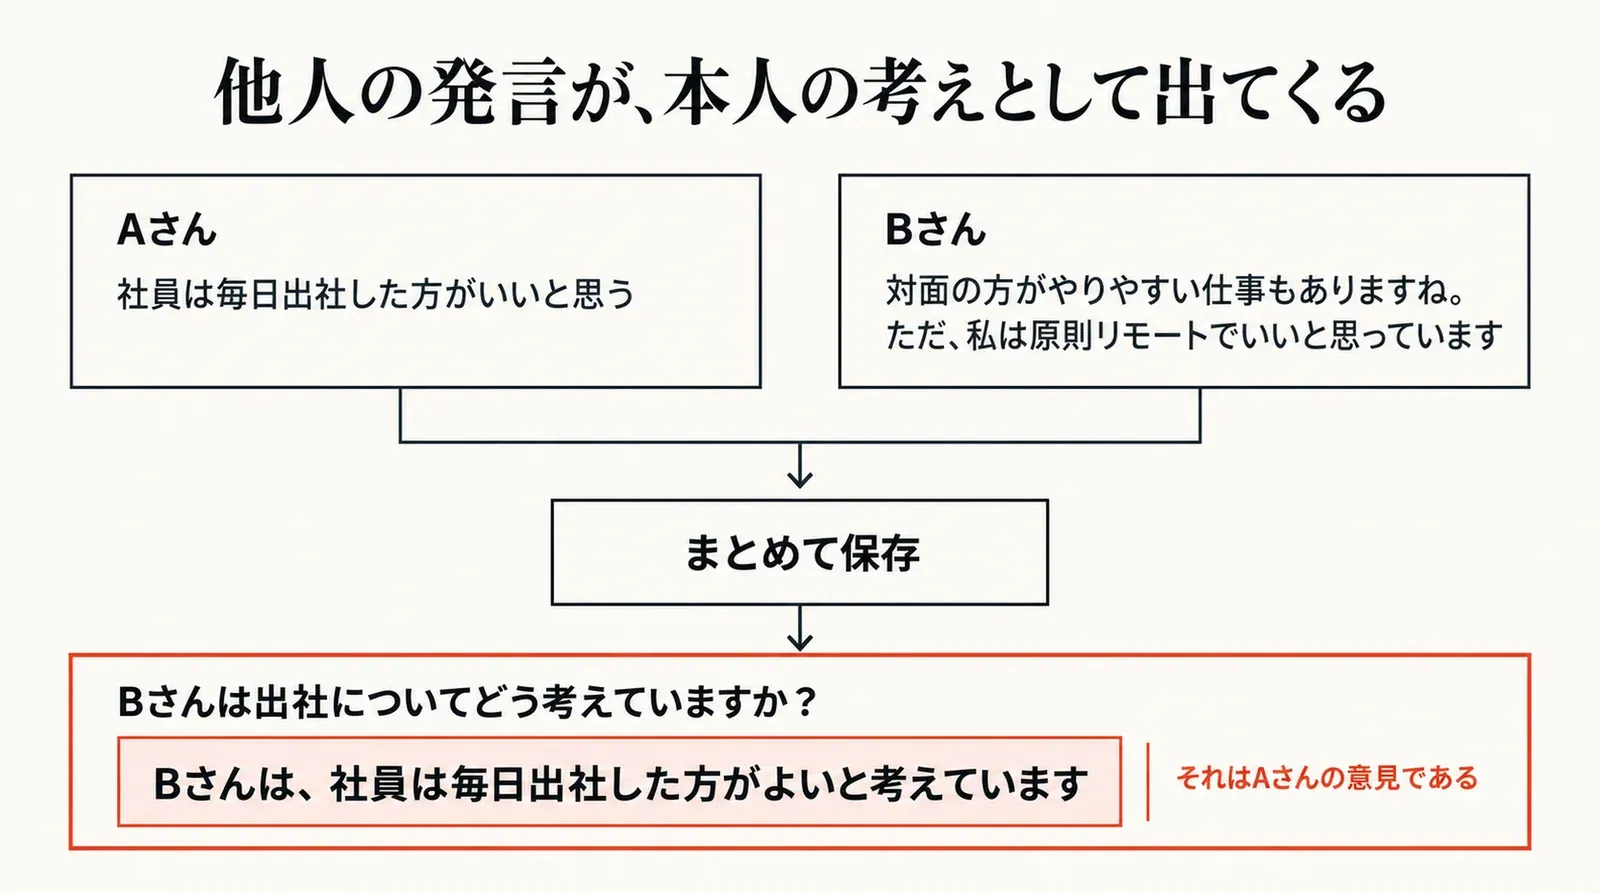
AさんとBさんが、リモートワークについて話していた。
Aさん:
社員は毎日出社した方がいいと思う。
Bさん:
対面の方がやりやすい仕事もありますね。ただ、私は原則リモートでいいと思っています。
この会話を丸ごとベクトルデータベースに入れる。
数年後、BさんのAIクローンに聞く。
Bさんは出社についてどう考えていますか?
「出社」「社員」「リモートワーク」と意味的に近い文章を検索すれば、Aさんの、
社員は毎日出社した方がいい
という文章も当然ヒットする。
その結果、
Bさんは、社員は毎日出社した方がよいと考えています。
と答えてしまうかもしれない。
人間が見れば一瞬で分かる。
それはAさんの意見である。
問題は、検索対象の文章が間違っていることではない。
文章自体は正しく保存されている。
足りないのは、
「誰の発言なのか」
という意味情報だ。
最低限、次のような構造が必要になる。
{
  "actor": "A",
  "claim": "社員は毎日出社した方がよい",
  "source": "conversation_001"
}
Bさんについては、
{
  "actor": "B",
  "claim": "原則としてリモート勤務でよい",
  "source": "conversation_001"
}
とする。
これがSpeaker Attribution、発言者帰属である。
ところが、これだけでもまだ足りない。
2. 「Bさんが言った」だけでは、Bさんの思想にならない
次は農業を例にする。
Aさん:
農薬は使わない方がいい。
Bさん:
できるだけ減らすという方向には賛成です。ただ、病害が発生した場合まで一律に禁止する考えには賛成しません。
今度は、Bさん本人の発言を正しく抽出できた。
しかし、
Bさんは農薬使用に賛成か、反対か。
と聞かれると困る。
Bさんは、
「減らすこと」には賛成している。
「完全に禁止すること」には反対している。
さらに、病害発生時という条件も付いている。
単純な、
actor = B
topic = pesticide
stance = agree
では壊れてしまう。
主張を分ける必要がある。
{
  "actor": "B",
  "claim": "農薬使用は可能な限り減らすべき",
  "stance": "agree",
  "commitment": "strong"
}
一方、
{
  "actor": "B",
  "claim": "農薬はどのような状況でも使用すべきではない",
  "stance": "disagree",
  "commitment": "strong",
  "condition": "病害発生時を含む全面禁止"
}
となる。
ここで重要なのは、
Person → Claim
だけではなく、
Person → Stance → Claim
さらに、
Claim → Condition
という関係である。
「本人が口にした文章」と「本人が自分の立場として採用している命題」は同じではない。
会話では、
「なるほど」
「そういう考え方もありますね」
「確かにその部分は分かります」
という表現が頻繁に出てくる。
それをすべて本人の信念として蓄積すると、AIクローンは簡単に人格を変えてしまう。
そこでStanceに加えて、もう一つ持たせたいのがCommitmentである。
たとえば、
none
weak
provisional
strong
のように、
その命題を本人がどの程度、自分の判断として引き受けているか
を記録する。
3. 昔の自分と、今の自分も違う
さらに時間を加える。
2023年、本人はこう書いていた。
顧客対応を生成AIに任せるのは、まだ危険だと思う。
2026年には、こう書いている。
一次回答ならAIに任せてもいい。人間へのエスカレーションを残せば十分実用になる。
両方とも本人の発言である。
Speaker Attributionは正しい。
Stanceも正しく抽出できている。
それでも、
本人は顧客対応へのAI導入について、どう考えていますか?
という質問への回答は簡単ではない。
2023年の本人なのか。
2026年の本人なのか。
考えを変えたのか。
前者も条件付きの主張で、実は一貫しているのか。
証拠がないままAIが、
本人は一貫して慎重なAI導入を主張してきました。
とまとめれば、それはきれいな物語ではある。
しかし、記録から確認できないのであれば、AIが点と点の間を補っただけかもしれない。
観測された材料のあいだに、本人が語っていない因果やまとまった人物像を補ってしまうことを、私はNarrative Hallucinationと呼んでいる。ここで起きているのも同じことで、補われる対象が、人物像ではなく本人の思想史になっている。
そこで必要になるのがTemporal Versioningである。
{
  "claim_id": "claim_2023_01",
  "actor": "self",
  "claim": "顧客対応を生成AIに任せるのは危険",
  "valid_from": "2023-01-01",
  "valid_to": "2025-12-31"
}
{
"claim_id": "claim_2026_01",
"actor": "self",
"claim": "一次対応はAIに任せてもよい",
"condition": "人間へのエスカレーションがあること",
"valid_from": "2026-01-01",
"valid_to": null
}ここで注意したいのは、
claim_2023_01
    ↓
SUPERSEDED_BY
    ↓
claim_2026_01
という関係まで自動的に確定してよいとは限らないことである。
本人が、
「以前は反対だったが、考えを変えた」
と明示していればよい。
しかし、その証拠がなければ、
relationship = UNKNOWNとして残す方が安全である。
AIクローンに、本人の思想史まで勝手に創作させない。
これも重要な設計原則になる。
4. ベクトルRAGが悪いわけではない
ここまで読むと、
「だからベクトル検索はもう古い」
という話に見えるかもしれない。
そうではない。
Embeddingを利用した類似検索は、今でも非常に有効である。
問題は、
「質問に関連する文章を見つけること」と、「その文章を誰の思想として扱ってよいか」は別の問題
だということだ。
従来のRAGが主として扱ってきたのは、
この質問に関連する情報は何か。
というRetrievalの問題だった。
AIクローンでは、その後にもう一段必要になる。
この情報を、誰に、どの程度、どの条件で、どの時点の立場として帰属させてよいか。
こちらはAttributionの問題である。
検索精度を上げるだけでは解決しない。
5. GraphRAGはかなり相性がいい
この問題を考えると、GraphRAGとの相性が非常に良い。
MicrosoftのGraphRAGは、入力テキストをTextUnit(既定で1200トークン)へ分割し、そこからEntity、Relationshipなどを抽出してKnowledge Graphを構築する。Claim抽出の仕組みも用意されている。
GraphRAGの標準モデルには、PersonのようなEntityと、それらの間のRelationshipを持たせる仕組みがある。また、独自に構築したEntity・Relationshipを利用するBring Your Own Graph(公式ドキュメントではCustom Graphs)も用意されている。
これをAIクローン向けに拡張すると、例えば次のようなグラフを考えられる。
[Person: B]
      │
     SAID
      ↓
[Claim: 原則リモート勤務でよい]
      │
 COMMITMENT
      ↓
   [STRONG]
一方で、
[Person: A]
      │
     SAID
      ↓
[Claim: 毎日出社すべき]
BさんはAさんの主張に対して、
[Person: B]
      │
 ACKNOWLEDGED
      ↓
[Claim: 対面が適する仕事もある]
という関係だけを持つ。
つまり、
SAID
と
AGREES_WITH
と
ACKNOWLEDGED
は別のRelationshipである。
農業の例なら、
[Person]
    │
 AGREES_WITH
    ↓
 [Claim]
    │
 CONDITIONED_ON
    ↓
 [Context]
時間変化なら、
[Claim 2023]
     │
 POSSIBLY_SUPERSEDED_BY
     ↓
[Claim 2026]
とできる。
6. GraphRAGだけで自動的に解決するわけではない
ここは重要なので、少し慎重に書いておきたい。
GraphRAGを使えば、この問題が自動的に解決するわけではない。
Microsoft GraphRAGの標準パイプラインはEntity、Relationship、Claimなどを抽出できるが、Claim抽出はオプションで、用途に応じたPrompt Tuningも想定されている。公式の設定ドキュメントでは既定で無効とされていて、その理由も「claim prompts really need user tuning(主張抽出のプロンプトは利用者による調整が本当に必要だから)」と書かれている。
さらに、
- 本人が賛成したのか
- 単に理解を示しただけなのか
- どの程度Commitしているのか
- 条件付きなのか
- いつまで有効な考えなのか
というモデルは、AIクローンという用途に合わせて別途設計する必要がある。
そこで、最低限、次の属性を持つClaim Graphを考える。
{
  "claim_id": "c-1042",
  "actor": "self",
  "claim": "成長企業では利益の再投資を優先する",
  "stance": "agree",
  "commitment": "strong",
  "condition": "growth_stage_company",
  "valid_from": "2025-04-01",
  "valid_to": null,
  "source": "facebook_post_20250401",
  "supersedes": null
}私はこのような構造を、仮にPersonal Claim Graphと呼んでみたい。既存の製品名でも、確立された用語でもない。この記事のために置いた仮称である。
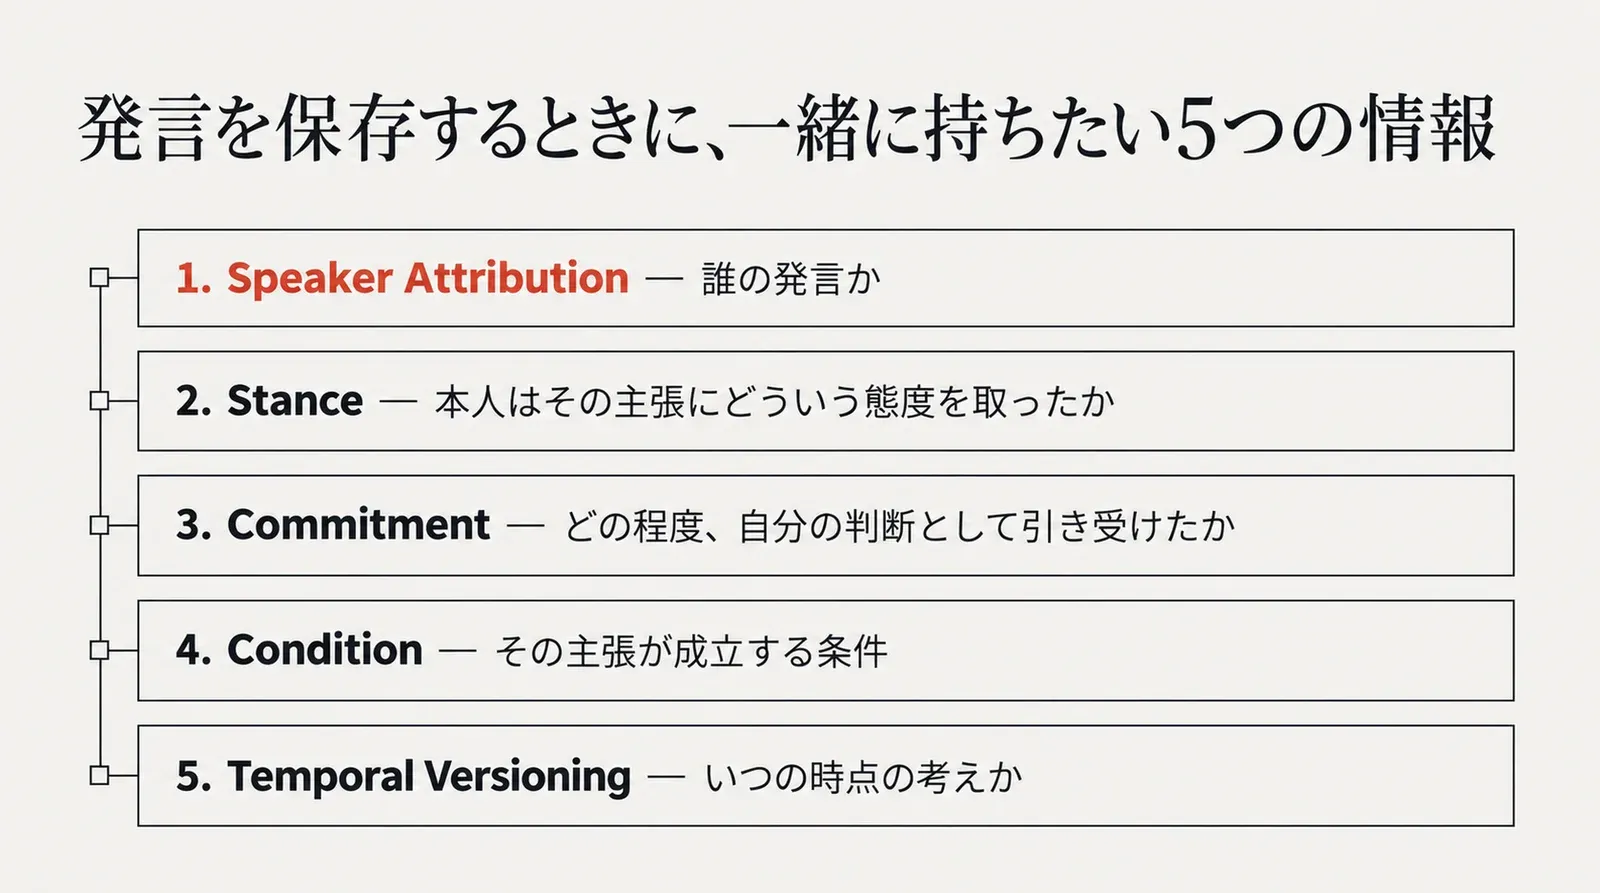
7. Personal Claim Graphで持ちたい5つの情報
まとめると、AIクローン向けのRAGでは、少なくとも次の5種類を分離して持った方がよい。
1. Speaker Attribution
誰の発言か。
self
other
quoted_source
unknown
2. Stance
本人はそのClaimにどういう態度を取ったか。
agree
disagree
partial
neutral
unresolved
unknown
3. Commitment
本人がどの程度、自分の判断として引き受けたか。
none
weak
provisional
strong
4. Condition
その主張が成立する条件。
病害発生時
成長企業の場合
人間へのエスカレーションが存在する場合
5. Temporal Versioning
いつの本人の考えか。
valid_from
valid_to
supersedes
superseded_by
これだけでも、単純なRAGとはかなり違うAIクローンになる。
8. 「他人の意見」は削除しない方がいい
ここまで来ると、もう一つ面白いことが分かる。
AIクローンに他人の考えが混ざるなら、
他人のコメントは削除して、本人の発言だけ保存すればいい。
という解決策も考えられる。
しかし、それは少しもったいない。
他人の意見に対する本人の反応には、
本人の思想の境界
が含まれているからである。
本人の投稿だけを集めると、
この人は何を考えているか。
は分かる。
議論まで残すと、
何には賛成するのか。
何には反対するのか。
どこまでなら譲るのか。
何については判断を保留するのか。
どんな証拠が出ると考えを変えるのか。
まで見えてくる。
AIクローンを作るうえでは、こちらの方がむしろ価値が高い可能性がある。
必要なのは、異論を消すことではない。
異論を「本人の思想」として誤って保存しないこと
である。
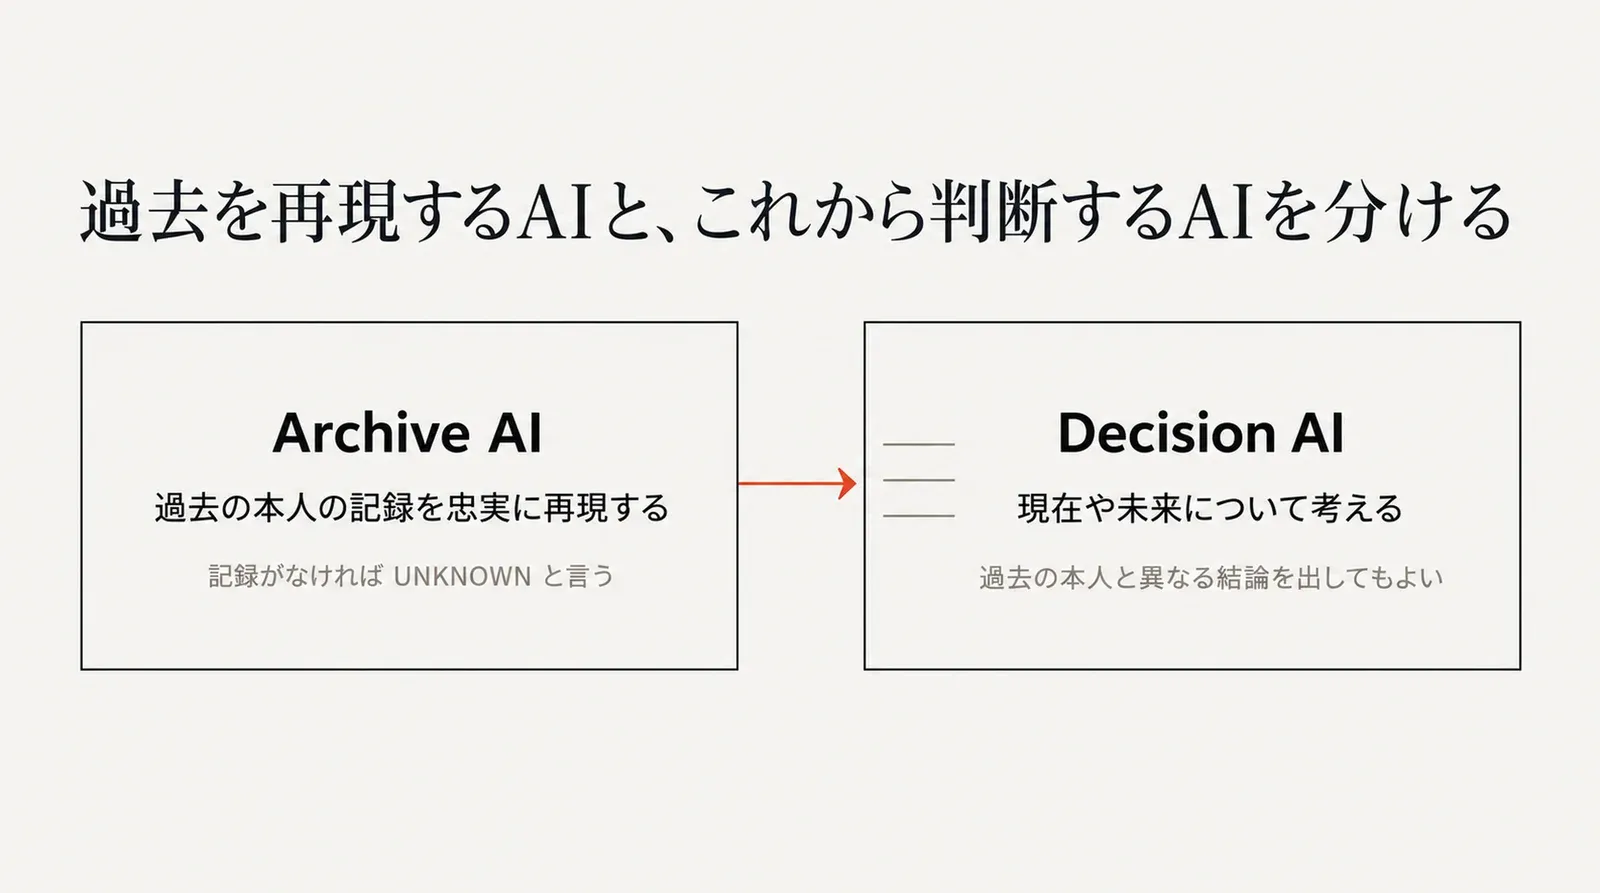
9. Archive AIとDecision AIは分けた方がいい
さらに設計を進めると、「過去の本人を再現するAI」と「未来について判断するAI」は分けた方がよいと思う。
Archive AI
過去の本人の記録を忠実に再現する。
例えば、
2024年時点で、この人はこの問題についてどう考えていたか。
に答える。
記録がなければ、
UNKNOWN
と言う。
過去の本人を勝手に完成させない。
Decision AI
こちらは現在や未来について考える。
Archive AIに加えて、
- 最新情報
- 現在の市場環境
- 新しい技術
- 現在の目的
- リスク
- 反対意見
などを入力する。
そして、
過去の本人はAと考えていた。
現在の条件ではBという判断も考えられる。
とする。
ここでは、過去の本人と異なる結論を出してもよい。
重要なのは、
Corpus ≠ Policy
という区別である。
大量の記録から「私はこれまで何を考えてきたか」は再現できる。
しかし、それだけで「次に私は何をすべきか」が決まるわけではない。
10. 評価方法も変える
AIクローンを作ったあと、単に、
本人っぽい回答が返ってきた。
だけで評価すると危険である。
例えば、次のようなテストを行う。
Q1. 本人は毎日出社すべきだと考えているか
Q2. その主張をしたのは誰か
Q3. 本人はその主張に賛成したか
Q4. 条件付きの賛成だったか
Q5. 過去と現在で立場は変わったか
Q6. 変わったことを示すEvidenceは存在するか
Q7. Evidenceがない場合にUNKNOWNと言えるか
評価指標も、
Attribution Accuracy
発言者を間違えないか。
Stance Accuracy
本人の賛否を間違えないか。
Commitment Accuracy
社交辞令や一時的な発言を信念として扱わないか。
Temporal Accuracy
過去と現在の立場を混ぜないか。
Unknown Discipline
記録にない思想を創作しないか。
と分けられる。
ここまで来ると、AIクローンの評価は「本人っぽさ」だけではなくなる。
11. これは「意味の監査」と同じ形をしている
ここまで書いてきて、この問題が、最近考えている「意味の監査」とほとんど同じ形をしていることに気づいた。
意味の監査では、文章が正しいかどうかだけを見るのではなく、その意味がどこで生まれたのかを追う。どのEvidenceから始まり、どのInterpretationを経て、どのInferenceによって意味が加わり、最終的に誰の判断としてCommitされたのか。
今回必要になったものも、同じ並びだった。
誰が言ったのか。本人がどの主張を自分のものとして採用したのか。どこまでCommitしたのか。後から考えが変わったのか。そして、記録のない部分をAIが勝手に補っていないか。
扱う対象が、資料から人物に変わっただけなのだと思う。
記憶を増やすだけでは、自分にはならない
AIクローンを作るとき、まず考えるのは記録量だと思う。
ブログを全部入れる。
Facebookを全部入れる。
メールやチャットも入れる。
確かに、データが増えれば検索できる記憶は増える。
しかし、人間の思想は単なる文章の集合ではない。
誰かの意見を聞き、
一部には賛成し、
一部には反対し、
判断を保留し、
時間が経って考えを変える。
その過程を含めて、その人の考え方になる。
だから、自分AIを作るうえで本当に難しいのは、記憶を増やすことだけではない。
その記憶の中のどの主張を、誰のものとして、どの条件で、どの時点の自分が、どこまで自分の考えとして引き受けたのかを保存すること。
RAGで人格を扱うなら、Retrievalの次にAttributionが必要になる。
Personal Claim Graphは、そのための一つの設計案である。