AIに本を書かせた2023年と、AIと意味を監査しながら書いた2026年
2023年、私はChatGPTに本を書いてもらった。2026年、もう一度AIと本を書いた。AIの利用量は増えたのに、原稿への関与はむしろ深くなった。変わったのは関与の量ではなく、何にコミットしていたかだった。
2023年、私はChatGPTに本を書いてもらった。2026年、もう一度AIと本を書いた。AIの利用量は増えたのに、原稿への関与はむしろ深くなった。変わったのは関与の量ではなく、何にコミットしていたかだった。
生成AIで網羅的な文章を作るコストがほとんどなくなった。情報をたくさん書けること自体は、もう希少ではない。未理解からの省略と、理解からの省略は外形が似ているが、中身はほとんど反対である。
自分の記録をAIに読み込ませて「自分AI」を作ると、記録の中にある他人の発言まで本人の思想として語り始める。これは検索精度とは少し違う問題で、Speaker Attribution・Stance・Commitment・Condition・Temporal Versioningを分けて持つ必要がある。
LISS Panelへのアクセスを断られ、代わりのデータを探し始めた。ところが調べてみると、AIペルソナやLLMによる社会調査データ生成について、すでにかなり近い研究と、検証に使える実データがいくつも存在していた。
若い頃の「海外に行く資格なんてあるのか」という一言に、AIは大真面目に資格要件を探し始めた。人間なら笑って流す一言をなぜAIは拾うのか。その失敗を眺めていたら、漫才と、人間が言葉で笑える理由が少し見えてきた。
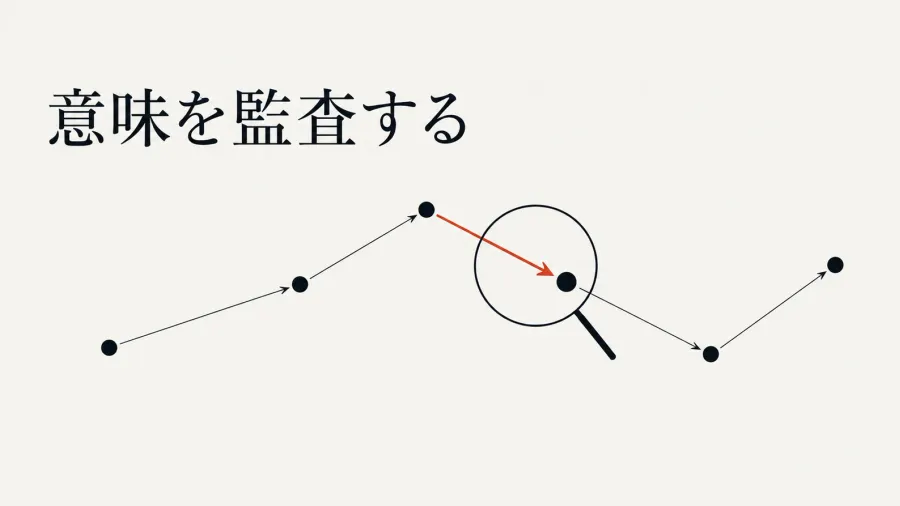
生成AIが作る文章は整っていて、読むと「なるほど」と思う。しかし点を渡したのは人間でも、点と点の間に線を引いたのはAIかもしれない。誤字脱字の校正では見つからない、その「→」の出所を追跡する「意味の監査」について。
多数決は正しい答えを決める仕組みではない。気になっていたのはその前、人の「意見」がどうやって作られたのかだった。Persona Monitorを作っていて、社会モデルには情報環境というレイヤーが必要だと気づいた話。
AIに自分のことを覚えさせるために、147回話し、31万文字を超えた。できたのはプロフィールではなかった。必要なのは属性ではなく条件で、AIの誤解も矛盾もUNKNOWNも残すことになった。Founder Corpusを作っている話。

AIで仮説の異なるモデルを100本並列に走らせられるなら、その価値は100個の中から一番良いモデルを選ぶことではない。99個を、正当な理由で捨てられることにある。Persona Monitorを作りながら考えたこと。

Persona Monitorを作っていて、質問したときにその人に答えさせてよいのかという問題に時間がかかっている。「わからない」と「対象ではない」は違い、回答が成立するまでには段階がある。そして同じことは、自分自身への問いにも言えた。
20年前、師匠はGISを「知識創造エンジン」と呼んだ。地図を作る道具ではなく、位置と時間という共通軸で情報を重ね、見えなかったものを発見する仕組みだと。生成AIで社会モデルを作りながら、同じものを作っていることに気づいた話。
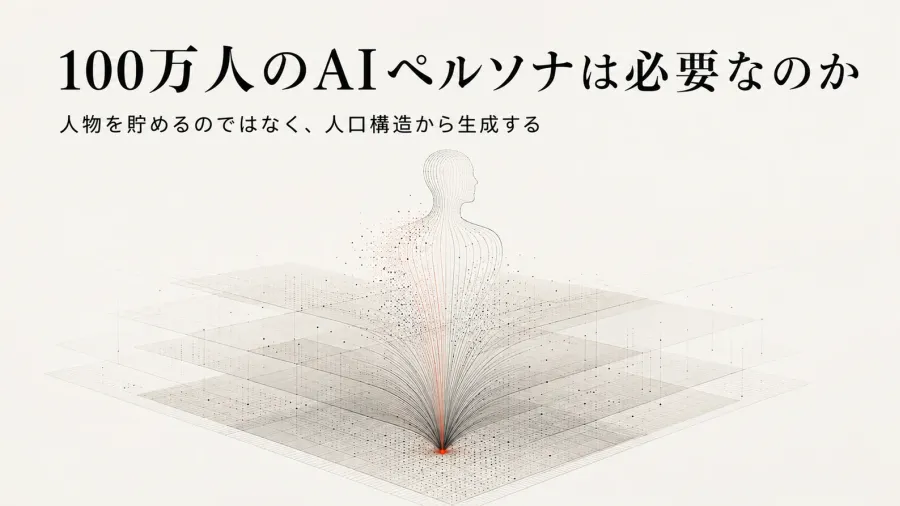
AIペルソナを反応を見るためのモデルとして考えると、債券ポートフォリオの感応度分析とよく似た構造が見えてくる。人物レコードを大量に用意する代わりに、人口構造をLayerとして持って必要なときにレンダリングする、という考え方について。