好きな食べ物は、やきそば。たぶん。
「好きな食べ物は?」と聞かれると、反射的に「やきそば」と答えてきた。嘘ではないが、純粋な嗜好調査の結果でもない。趣味、ホーム、好きな食べ物。自己紹介で差し出す短い答えは、本体ではなく取っ手なのかもしれない。
全 13 本・新しい順
「好きな食べ物は?」と聞かれると、反射的に「やきそば」と答えてきた。嘘ではないが、純粋な嗜好調査の結果でもない。趣味、ホーム、好きな食べ物。自己紹介で差し出す短い答えは、本体ではなく取っ手なのかもしれない。
LISS Panelへのアクセスを断られ、代わりのデータを探し始めた。ところが調べてみると、AIペルソナやLLMによる社会調査データ生成について、すでにかなり近い研究と、検証に使える実データがいくつも存在していた。
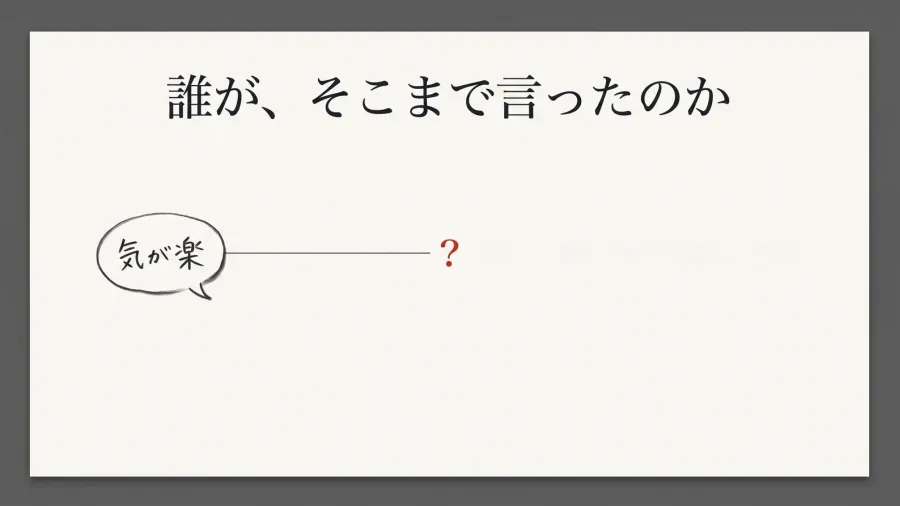
AIに議事録を作らせると、「気が楽」は「心理的負担が軽減された」になる。文章としてはよくできている。でも、その少しの間にいくつかの意味が追加されている。その一文は、誰が言ったことなのか。
「週20時間必要」と「2人必要」は同じ種類の意味ではない。報告資料に意味の監査を試したら、条件と提案の間に余計な矢印が入っていた。意味が混じると異論の場所が分からなくなり、議論は止まる。
「なぜ〇〇は△△なのか」というタイトルは、秘密を隠しているわけではない。隠されているのは、その二つを結ぶものだけだ。情報をいつ出すかと、意味をいつ確定するかは同じではない、という話。
若い頃の「海外に行く資格なんてあるのか」という一言に、AIは大真面目に資格要件を探し始めた。人間なら笑って流す一言をなぜAIは拾うのか。その失敗を眺めていたら、漫才と、人間が言葉で笑える理由が少し見えてきた。
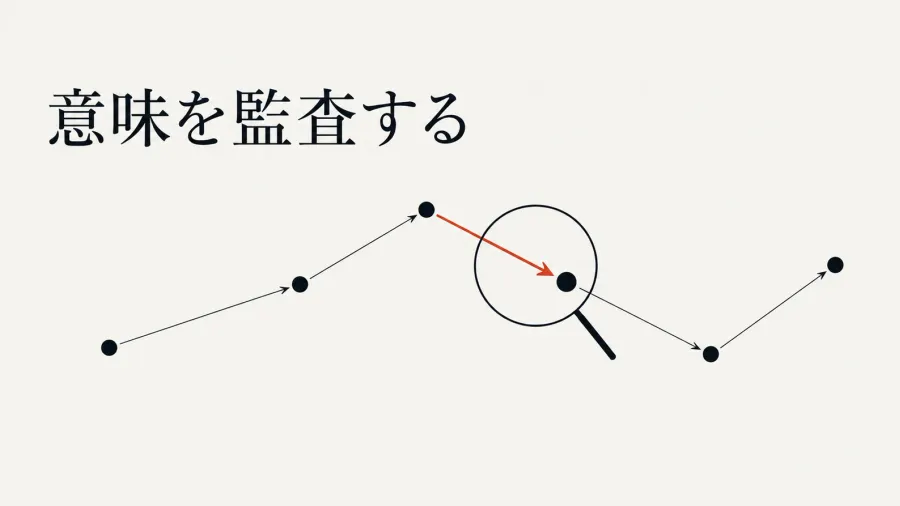
生成AIが作る文章は整っていて、読むと「なるほど」と思う。しかし点を渡したのは人間でも、点と点の間に線を引いたのはAIかもしれない。誤字脱字の校正では見つからない、その「→」の出所を追跡する「意味の監査」について。
多数決は正しい答えを決める仕組みではない。気になっていたのはその前、人の「意見」がどうやって作られたのかだった。Persona Monitorを作っていて、社会モデルには情報環境というレイヤーが必要だと気づいた話。
AIに自分のことを覚えさせるために、147回話し、31万文字を超えた。できたのはプロフィールではなかった。必要なのは属性ではなく条件で、AIの誤解も矛盾もUNKNOWNも残すことになった。Founder Corpusを作っている話。

AIで仮説の異なるモデルを100本並列に走らせられるなら、その価値は100個の中から一番良いモデルを選ぶことではない。99個を、正当な理由で捨てられることにある。Persona Monitorを作りながら考えたこと。

Persona Monitorを作っていて、質問したときにその人に答えさせてよいのかという問題に時間がかかっている。「わからない」と「対象ではない」は違い、回答が成立するまでには段階がある。そして同じことは、自分自身への問いにも言えた。
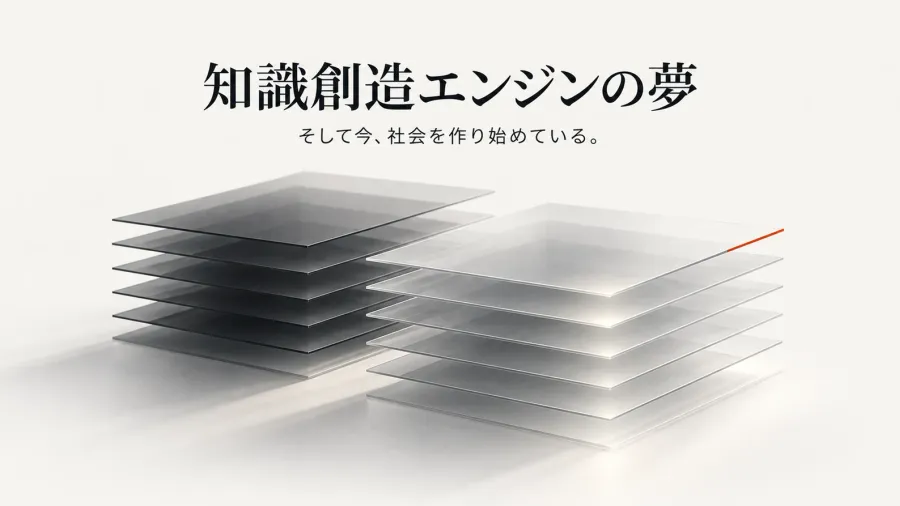
20年前、師匠はGISを「知識創造エンジン」と呼んだ。地図を作る道具ではなく、位置と時間という共通軸で情報を重ね、見えなかったものを発見する仕組みだと。生成AIで社会モデルを作りながら、同じものを作っていることに気づいた話。
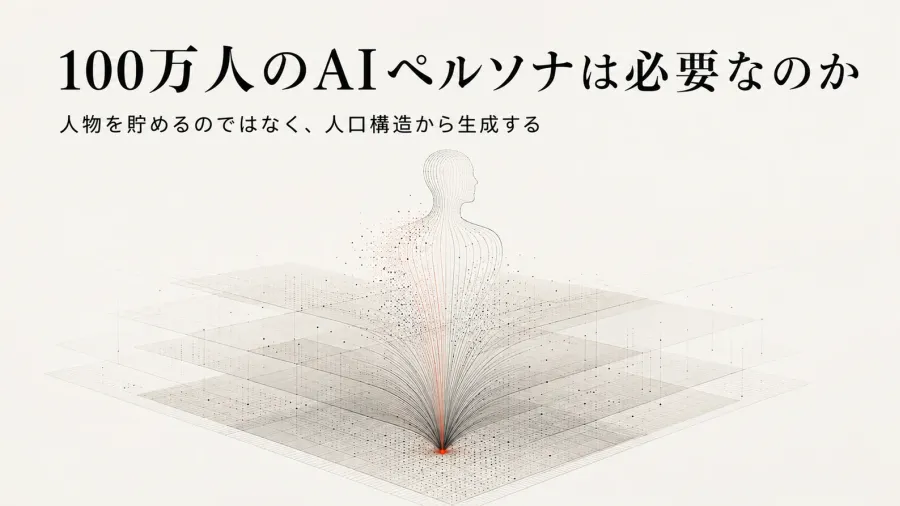
AIペルソナを反応を見るためのモデルとして考えると、債券ポートフォリオの感応度分析とよく似た構造が見えてくる。人物レコードを大量に用意する代わりに、人口構造をLayerとして持って必要なときにレンダリングする、という考え方について。