· 技術革新とデジタルトレンド · シリーズ: テクノロジーの現在地 · 読了目安 8 分
研究データへのアクセスを断られて、AIペルソナ研究の地図が見えてきた
Persona Monitorという、AIペルソナを人口集団として扱うモデルの研究を進めている。
その検証に使えないかと考えていたのが、オランダのLISS Panelだった。しかし利用申請について何度かやり取りした結果、今回はアクセスを認めないという最終回答を受けた。
仕方がないので、別のデータを探すことにした。
ところが調べてみると、単なる「LISSの代わり探し」では済まなかった。
AIペルソナやLLMによる社会調査データの生成について、かなり近い研究がすでに進んでいる。そして、それを検証するために使えそうな実データもいくつも存在していた。
すでに、かなり近い研究がある
特に重要なのが、2026年にPNASに掲載された Evaluating the statistical realism of LLM-generated social science data だった。
この研究では、15のLLMを、4つの縦断データと3つの横断データを使って評価している。
評価対象も、単に「人間らしい回答をするか」ではない。
回答分布、変数間の関連、多変量予測、人生イベントの系列など、実際の人間集団に存在する統計的構造をLLMが再現できるかを検証している。
PNAS: Evaluating the statistical realism of LLM-generated social science data
関連研究を整理すると、現在の地図はおおむね次のようになる。
| 研究 | 主な論点 | Persona Monitorとの関係 |
|---|---|---|
| PNAS / SSDataBench | LLM生成データは実社会の統計構造を再現できるか | Population-level realismの重要なbaseline |
| Twin-2K-500 / Digital Twin | 実在する個人の大量の回答から、その人の未観測回答をLLMで予測 | Persona Monitorに非常に近い検証領域 |
| Rich conditioning研究 | 人物について与える情報を増やすと再現性は上がるか | Layered Person Modelと直接関係 |
| Psychological conditioning研究 | 心理属性などが個人差の再現に有効か | Personaのlayer設計と関係 |
| Attribute utilization研究 | 多数の属性を与えたときLLMは本当に利用しているか | 「情報を増やせばよい」とは限らない |
| Abstention / UNKNOWN研究 | LLMに「答えない」を許すと何が起きるか | Persona MonitorのAnswerabilityと関係 |
| Persona distortion研究 | LLMによる人間・集団の再現にはどんな歪みがあるか | failure taxonomyとの比較対象 |
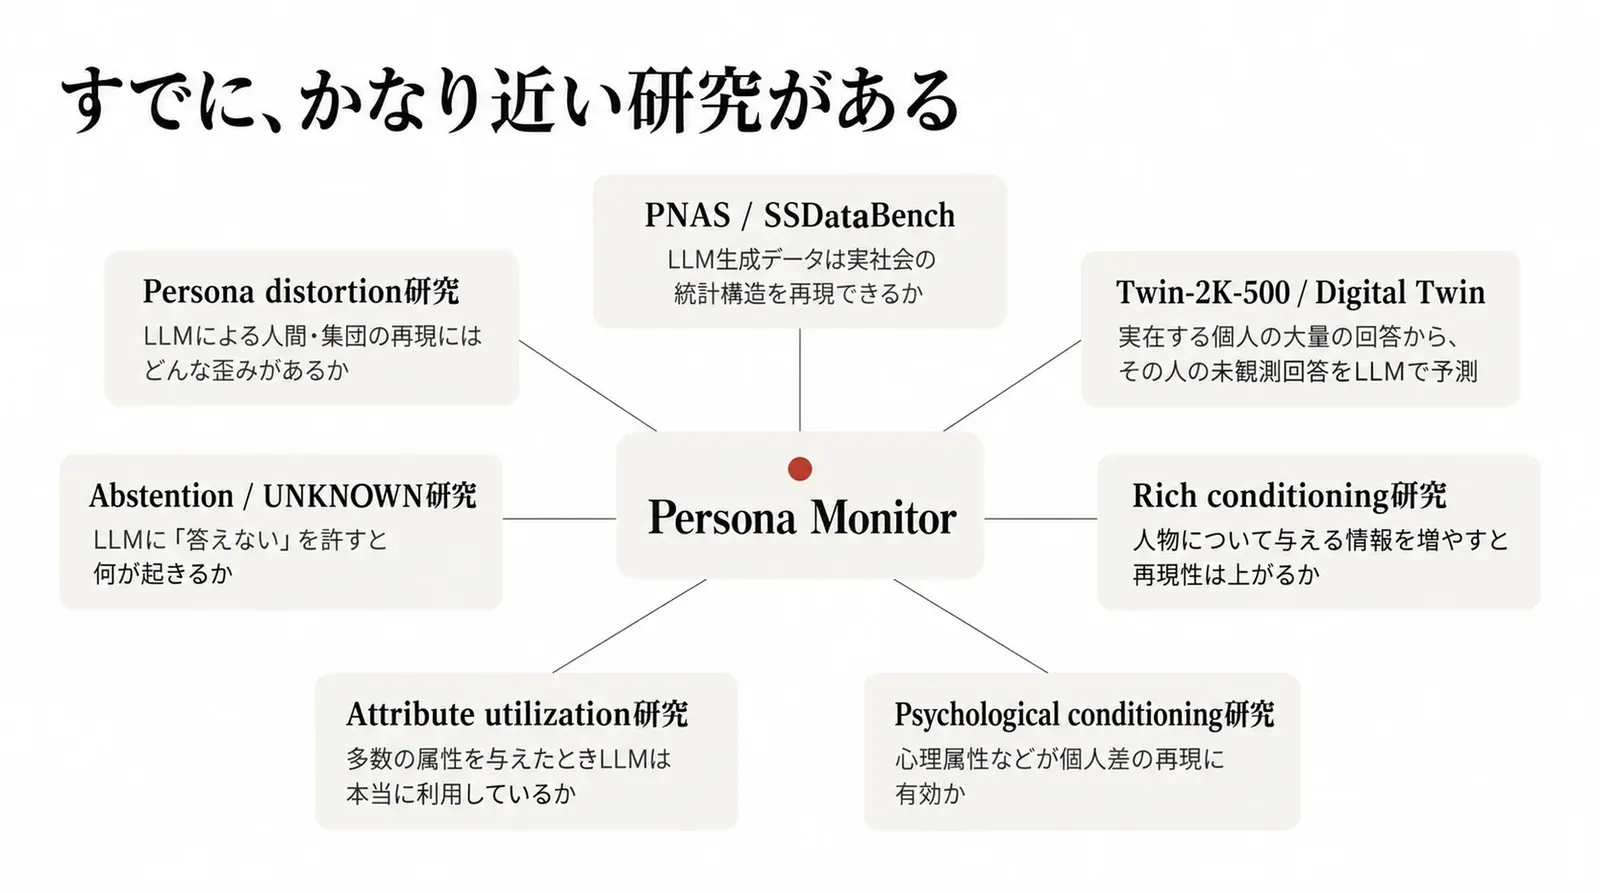
調べていて重要だったのは、Persona Monitorで考えてきた区別のいくつかが、すでに別の研究でも検証され始めていることだった。
「AIペルソナについて考えました」だけでは、研究としての新規性にはならない。
むしろここからは、既存研究でまだ検証されていないものは何かを探すことになる。
使えそうな実データもかなりある
データセットについても、LISSだけが選択肢ではなかった。
| Dataset | 種類 | Persona Monitorでの用途候補 |
|---|---|---|
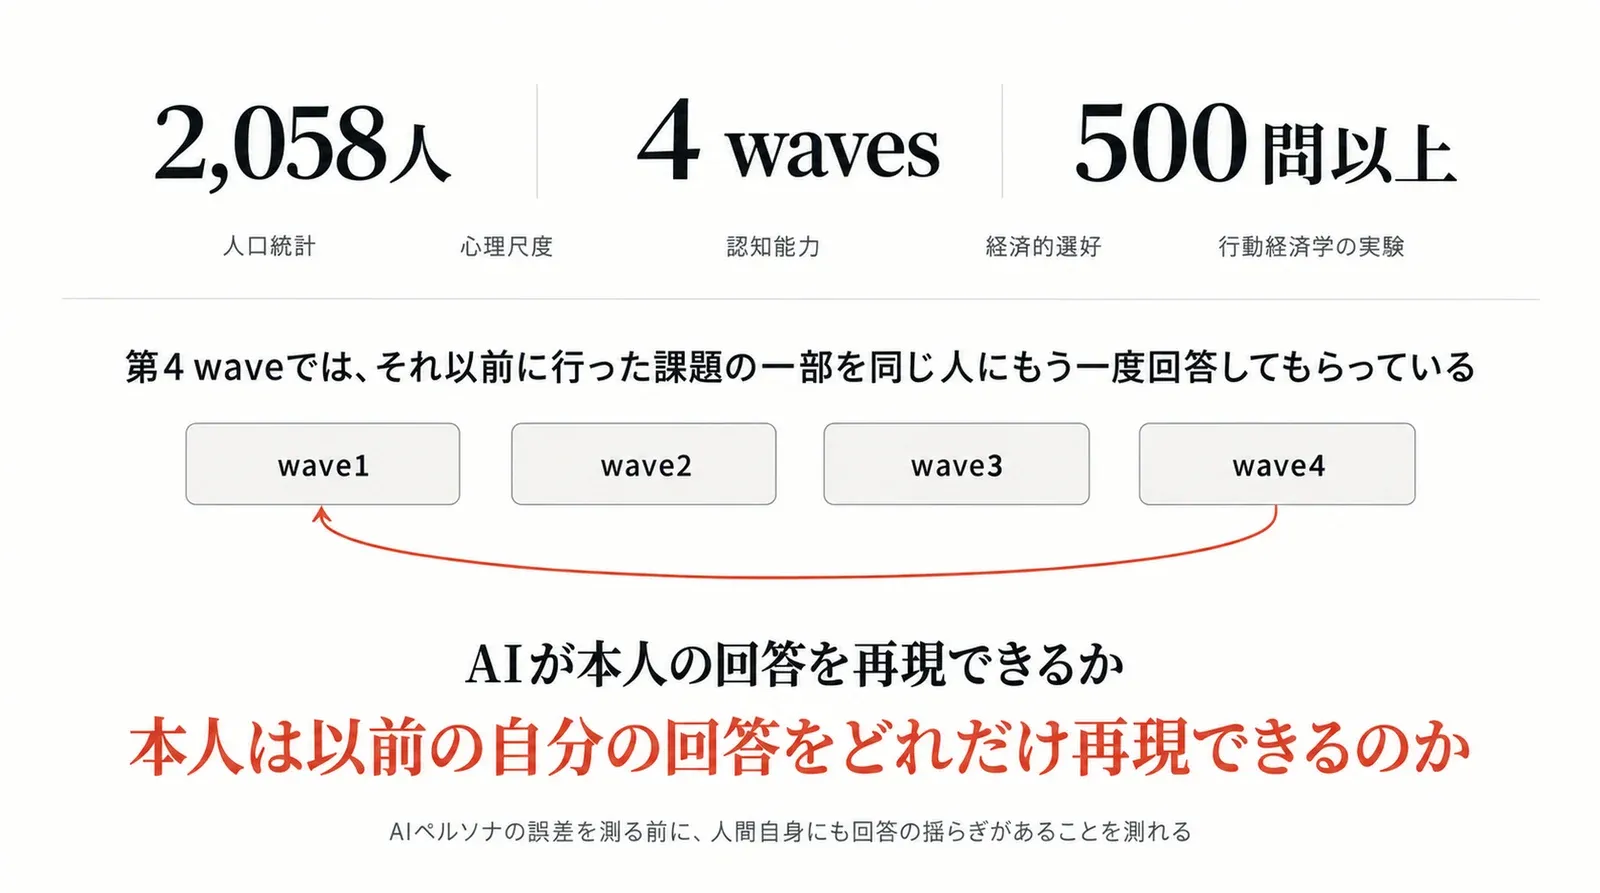
| Twin-2K-500 | 2,058人、4 waves、500問以上 | Layered Persona、individual fidelity、人間自身のtest-retest |
| GSS | 米国社会調査 | UNKNOWN / Don’t know / No answer、population distribution |
| NLSY79 | 米国longitudinal panel | longitudinal trajectory、個人の時間変化 |
| Understanding Society | 英国大規模panel | longitudinal persona、社会・行動変化 |
| Understanding America Study | 米国probability internet panel | LISSに近いpanel型研究 |
| World Values Survey | 国際repeated cross-section | 国・時点別population distribution |
| European Values Study | 欧州repeated cross-section | 価値観・文化差・時間変化 |
| European Social Survey | 欧州cross-national survey | subgroup / population realism |
| GESIS Panel | ドイツprobability panel | longitudinal validation |
| ALLBUS | ドイツ社会調査 | population / subgroup reproduction |
| CFPS | 中国family panel | longitudinal / family / social context |
| Add Health | 米国longitudinal cohort | longitudinal person-level validation。ただしアクセス制約あり |
中でも面白いのがTwin-2K-500だった。
米国の2,058人が4回にわたって500問以上に回答している。人口統計だけでなく、心理尺度、認知能力、経済的選好、行動経済学の実験なども含まれる。
さらに第4 waveでは、それ以前に行った課題の一部を同じ人にもう一度回答してもらっている。
つまり、
AIが本人の回答を再現できるか
だけではなく、
本人は以前の自分の回答をどれだけ再現できるのか
まで比較できる。
これは面白い。
AIペルソナの誤差を測る前に、人間自身にも回答の揺らぎがあることを測れるからだ。
NLSY79のように、同じ人々を長期間追跡している公開データもある。NLSY79は1979年から続く縦断調査で、public-use dataは無料で利用できる。
データセットを選ぶ前に、問いを選ぶ
今回の調査で考え方が少し変わった。
最初は、
LISSが使えない。代わりのデータセットを探そう。
だった。
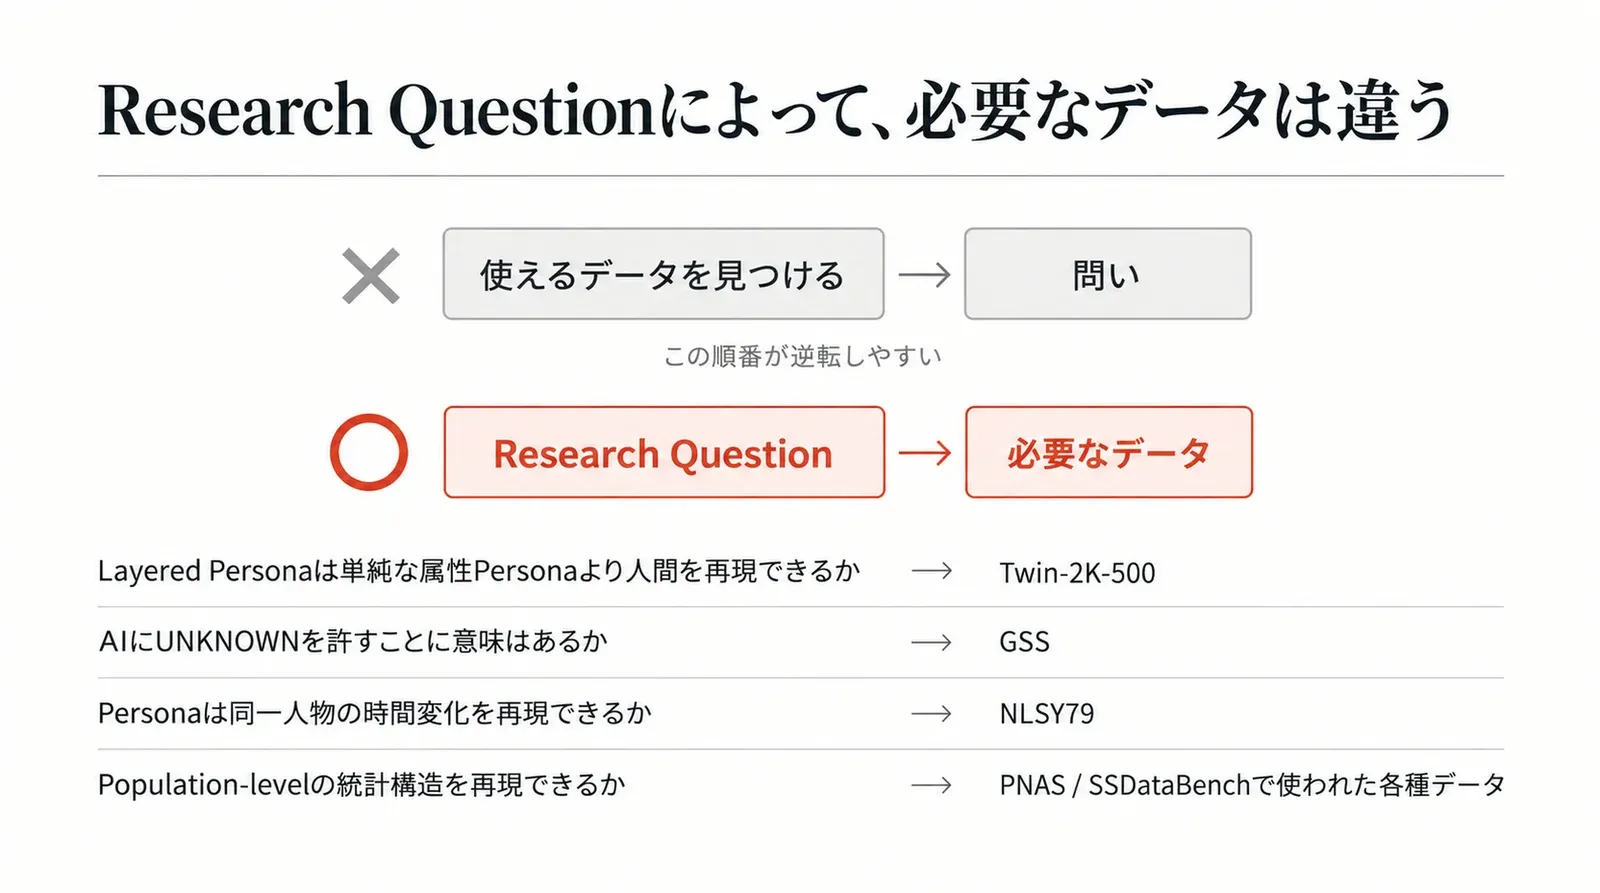
しかし、実際には先に決めるべきなのはデータセットではなかった。
たとえば、
| 問い | 有力なデータ候補 |
|---|---|
| Layered Personaは単純な属性Personaより人間を再現できるか | Twin-2K-500 |
| AIにUNKNOWNを許すことに意味はあるか | GSS |
| Personaは同一人物の時間変化を再現できるか | NLSY79 |
| Population-levelの統計構造を再現できるか | PNAS / SSDataBenchで使われた各種データ |
Research Questionによって、必要なデータは違う。
当たり前の話なのだが、「使えるデータを見つける」ことから始めると、この順番が逆転しやすい。
そして、今回は新しい装置を作らない
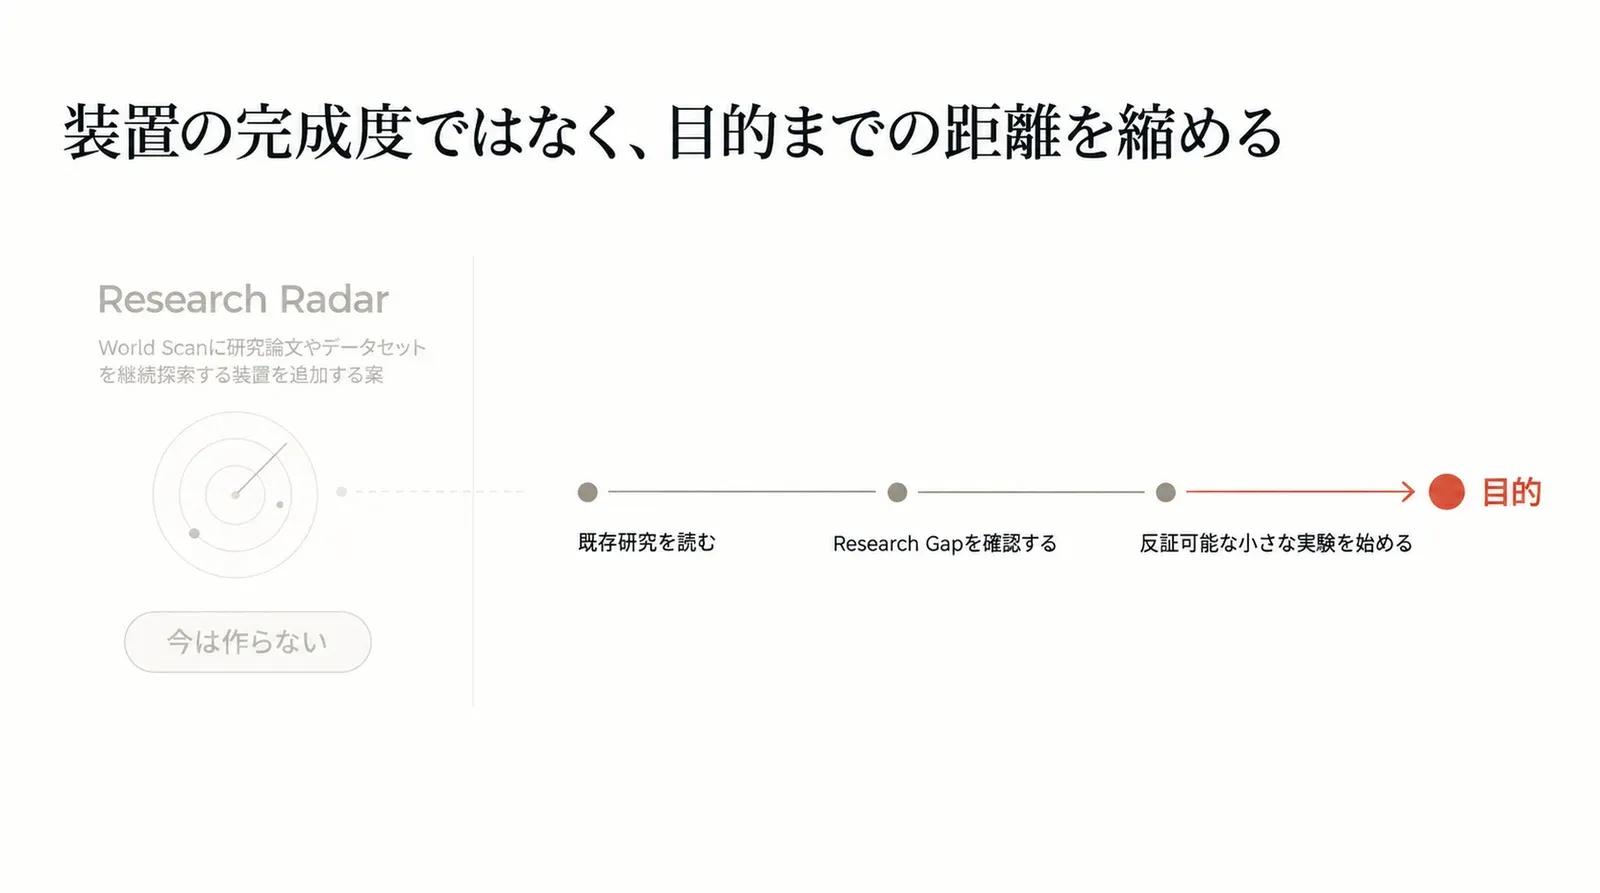
この調査を始めるとき、World Scanに研究論文やデータセットを継続探索するResearch Radarを追加する案も考えた。
結論として、今は作らないことにした。
必要な先行研究はすでにかなり見つかった。実験に使えそうなデータも見つかった。
ここから必要なのは探索装置を精密にすることではなく、既存研究を読み、Research Gapを確認し、反証可能な小さな実験を始めることである。
最近、研究開発をしていて意識するようになったことがある。
装置の完成度ではなく、目的までの距離を縮める。
LISSへのアクセスは得られなかった。
でも、その代わりにAIペルソナ研究の現在地と、自分たちが次に調べるべき場所が少し見えてきた。
結果として、これはこれで悪くない。