· 技術革新とデジタルトレンド · シリーズ: テクノロジーの現在地 · 読了目安 7 分
「気が楽」を「心理的負担が軽減された」にしてはいけない
AIに会話の書き起こしから議事録を作らせていると、よく出会う文章がある。
たとえば、こんな発言があったとする。
「気が楽」
「集中できますね」
AIに議事録としてまとめてもらうと、こうなる。
「心理的負担が軽減され、集中できるようになった」
私は、これがとても嫌だ。
文章としてはおかしくない。
むしろ、よくできている。
「気が楽」という話し言葉を「心理的負担が軽減された」と整え、「集中できますね」を「集中できるようになった」とまとめる。
意味も、だいたい合っているように見える。
本人に確認しても、
「まあ、そういう意味です」
と言うかもしれない。
それでも、自分が文責を持つ議事録なら、私はこの文章をそのまま残したくない。
なぜ、こんなに気になるのだろう。
考えてみると、これは昔、官僚として仕事をしていたときに、かなり徹底してしつけられた感覚だった。
誰が、そこまで言ったのか
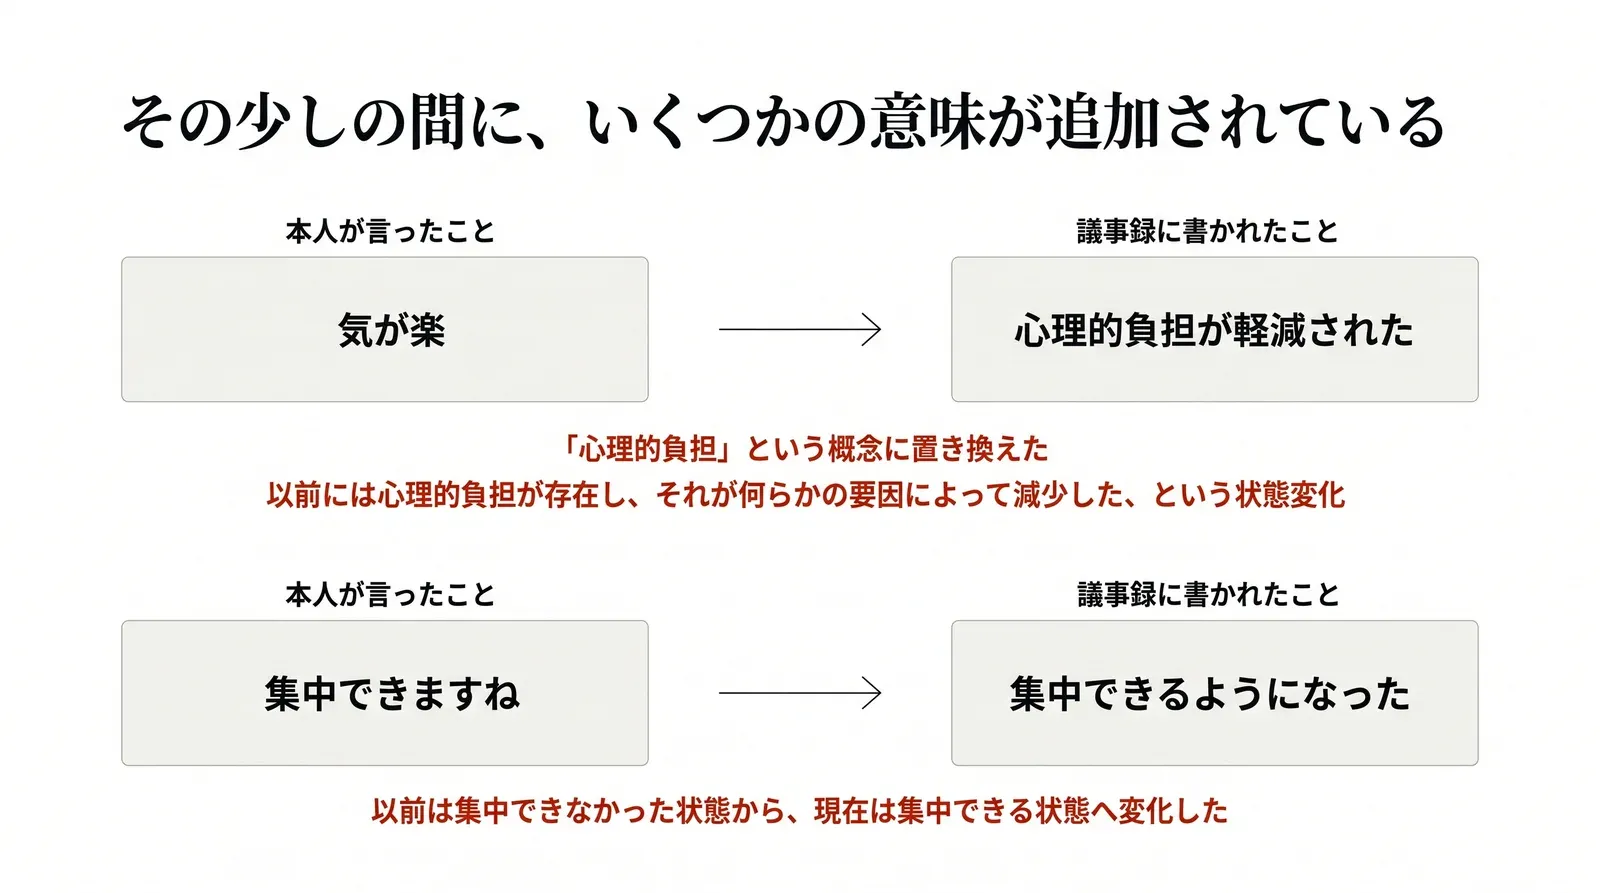
「気が楽」と「心理的負担が軽減された」。
この二つは似ている。
でも、同じではない。
本人が言ったのは「気が楽」だ。
それを「心理的負担」という概念に置き換えたのは、議事録を書いた側である。
さらに「負担が軽減された」と書けば、以前には心理的負担が存在し、それが何らかの要因によって減少した、という状態変化まで含まれてくる。
「集中できますね」も同じだ。
その場で「これなら集中できますね」と感想を述べただけかもしれない。
ところが、
「集中できるようになった」
と書くと、以前は集中できなかった状態から、現在は集中できる状態へ変化した、という記述になる。
ほんの少しの違いである。
けれど、その少しの間に、いくつかの意味が追加されている。
AIは要約しただけなのか
これを分解してみると、面白い。
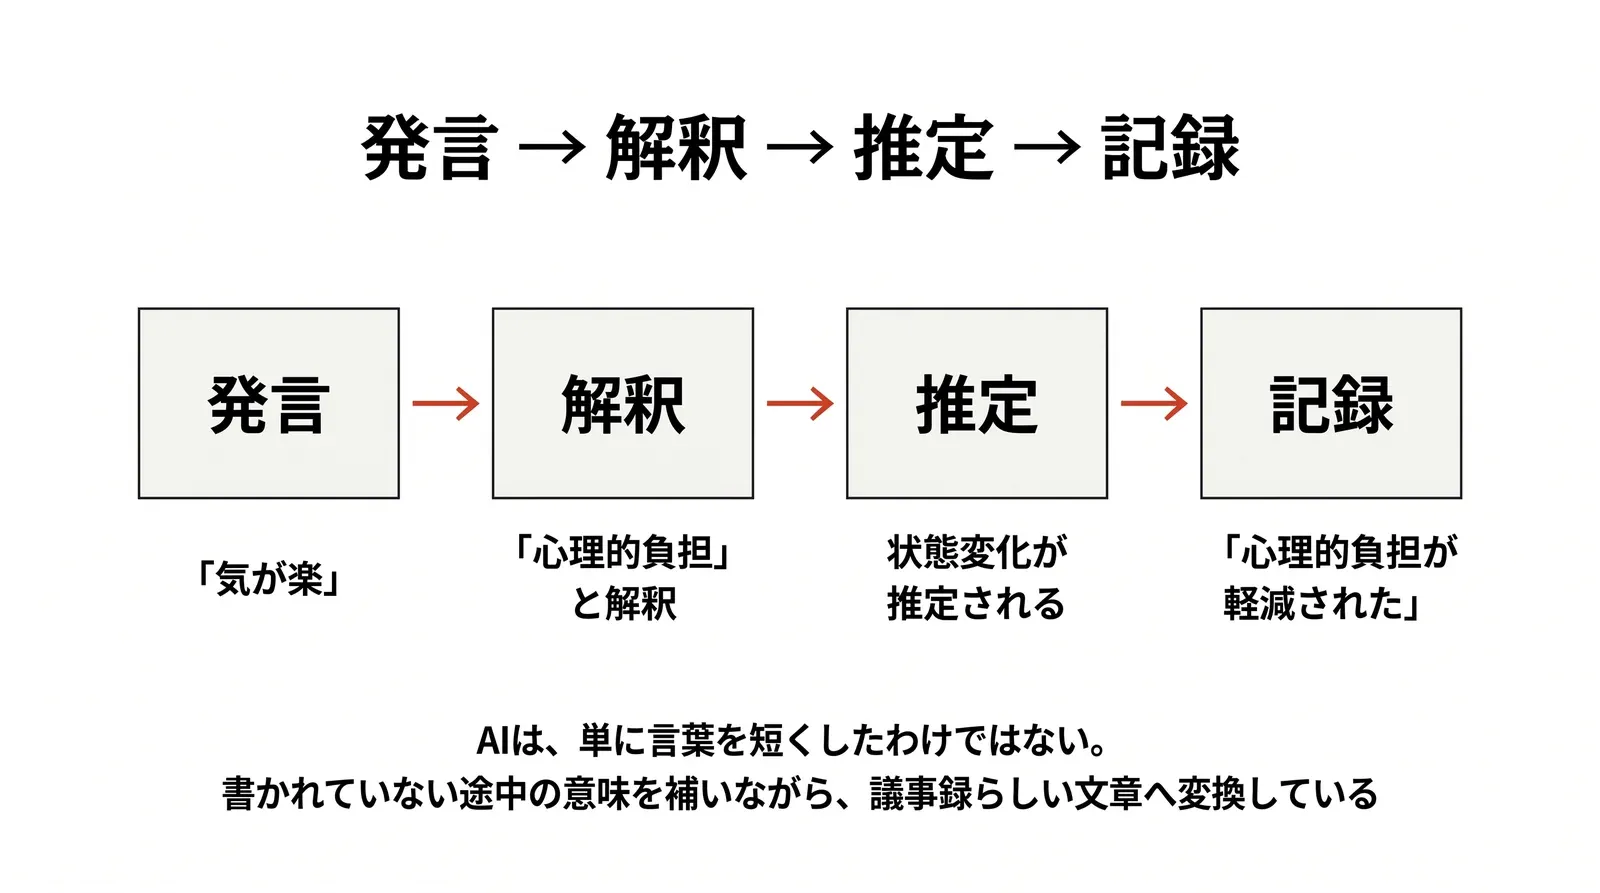
「気が楽」
という発言が、
「心理的負担」
と解釈される。
そこから、
「心理的負担が軽減された」
という状態変化が推定される。
つまり、
発言 → 解釈 → 推定 → 記録
という変換が起きている。
「集中できますね」についても、
発言 → 状況の解釈 → 前後の状態の推定 → 「できるようになった」という記録
へ変わっている。
AIは、単に言葉を短くしたわけではない。
書かれていない途中の意味を補いながら、議事録らしい文章へ変換している。
そして、おそらくAIはこういうことが得意なのだ。
話し言葉には省略が多い。
主語がなかったり、途中で話が飛んだり、曖昧な表現があったりする。
それをそのまま並べても、読みやすい議事録にはならない。
だからAIは文脈を読み、足りないところを補い、きれいな文章にする。
それ自体は、とても便利な能力である。
問題は、その途中で何が補われたのかが見えにくいことだ。
文章がきれいになるほど、境界が消える
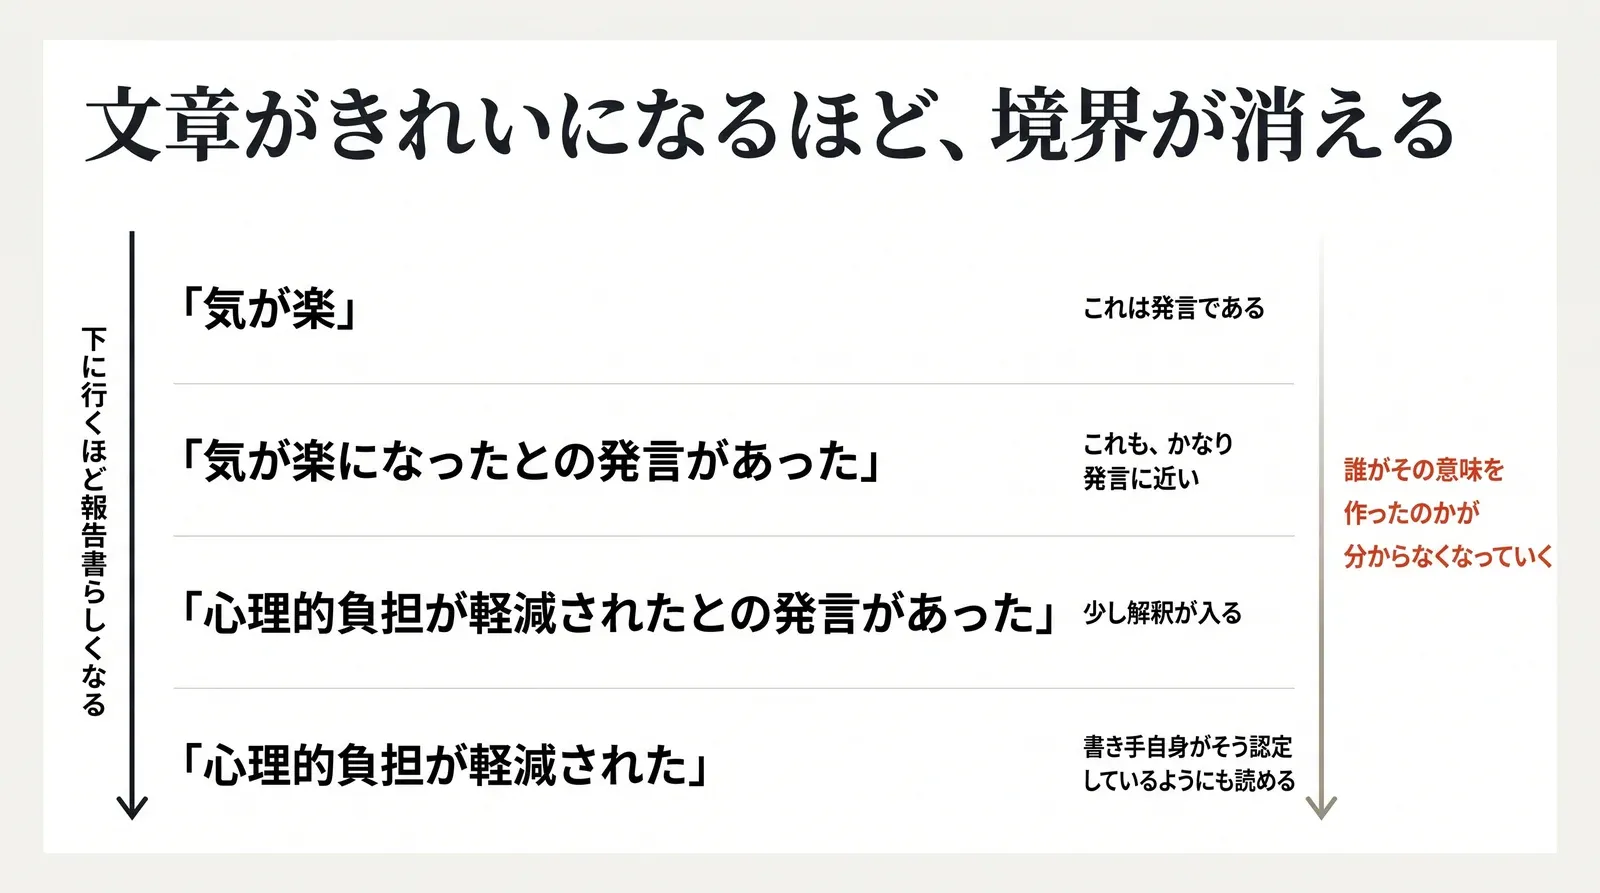
少し意地悪に並べてみる。
「気が楽」
これは発言である。
「気が楽になったとの発言があった」
これも、かなり発言に近い。
「心理的負担が軽減されたとの発言があった」
少し解釈が入る。
「心理的負担が軽減された」
ここまで来ると、書き手自身がそう認定しているようにも読める。
文章としては、下に行くほど報告書らしくなる。
ところが同時に、
誰がその意味を作ったのか
が分からなくなっていく。
これは、AIだから起きる問題ではない。
人間が議事録を書いても、同じことは昔から起きていた。
私自身も、他人が作った議事録なら気づかずに読んでしまうことがあると思う。
自分に直接関係しないところなら、そこまで神経を使わないかもしれない。
だから、この感覚には個人差もあるのだろう。
ただ、自分が文責を持つとなると、急に気になる。
「そこまで本人は言っていたっけ?」
と立ち止まりたくなる。
「要約」と「解釈」の境目
もちろん、議事録ですべての発言を一字一句そのまま残す必要はない。
それなら書き起こしを保存すればいい。
議事録には要約が必要だ。
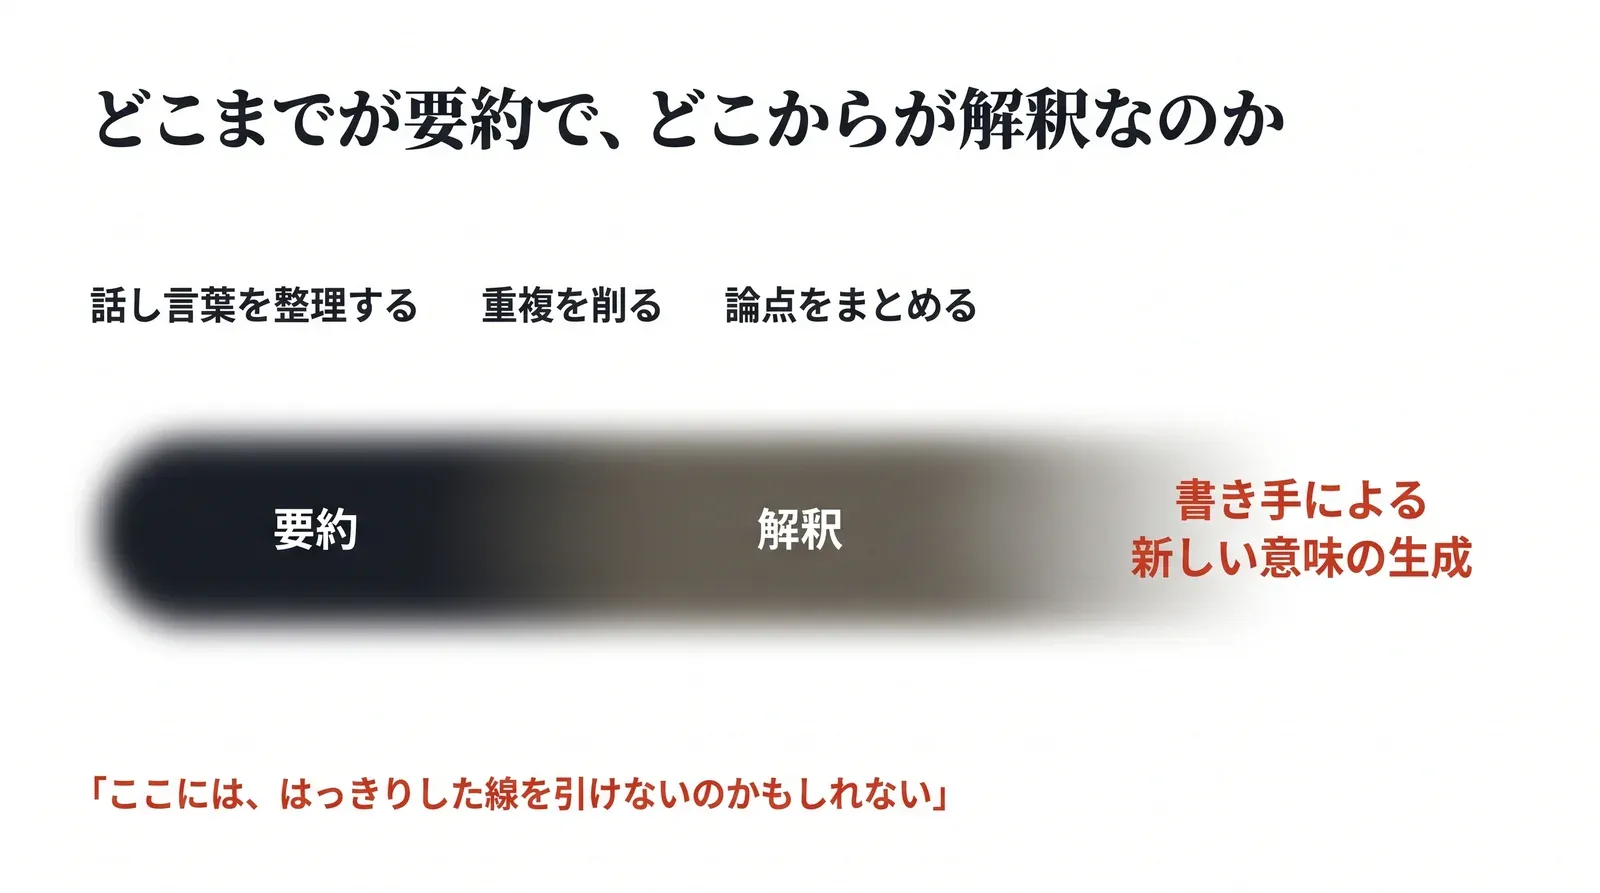
話し言葉を整理することも必要だし、重複を削り、論点をまとめることも必要になる。
だから、
「意味を一切変えてはいけない」
と言いたいわけではない。
むしろ難しいのは、
どこまでが要約で、どこからが解釈なのか
なのだと思う。
さらに言えば、
どこからが、書き手による新しい意味の生成なのか。
ここには、はっきりした線を引けないのかもしれない。
AIによって、この問題は大きくなった
人間が議事録を書いていたころにも、この問題はあった。
でも、人間が書くには時間がかかった。
会話を聞き直し、メモを見て、文章を考える。
その途中で、
「いや、この人はそこまで言っていないな」
と手が止まることもあった。
AIは止まらない。
大量の会話から、数十秒で整った議事録を作る。
しかも文章が自然だから、読む側もそのまま受け入れやすい。
誰も言っていないことを、とんでもない内容に捏造するわけではない。
むしろ逆である。
誰もが「まあ、そういう意味だよね」と納得しそうな文章にする。
だから気づきにくい。
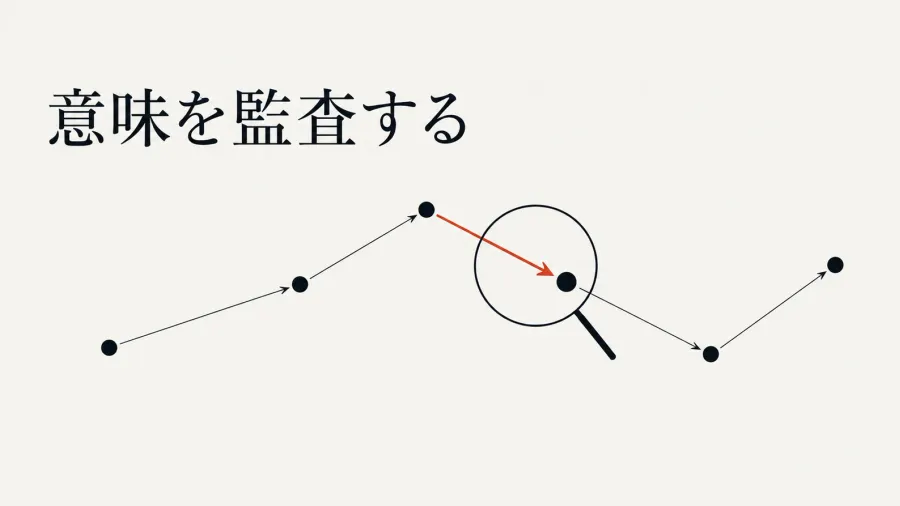
最近考えている「意味の監査」というものも、たぶんこういうところに関係している。
事実が間違っているかどうかだけではなく、
ある発言から、どのように意味が作られ、その意味がどこで事実らしい記述に変わったのか。
その途中を追ってみる。
今回の例なら、
「気が楽」
↓
「心理的負担がある」と解釈
↓
その負担が以前より減ったと推定
↓
「心理的負担が軽減された」と記録
となる。
最後の文章だけを読めば自然だ。
でも矢印を開いてみると、その途中には本人が明示的には言っていないことがある。
どこまで気にするべきなのだろう
ここまで書いておいて、すべての議事録でこんなことを徹底すべきだ、と言うつもりはない。
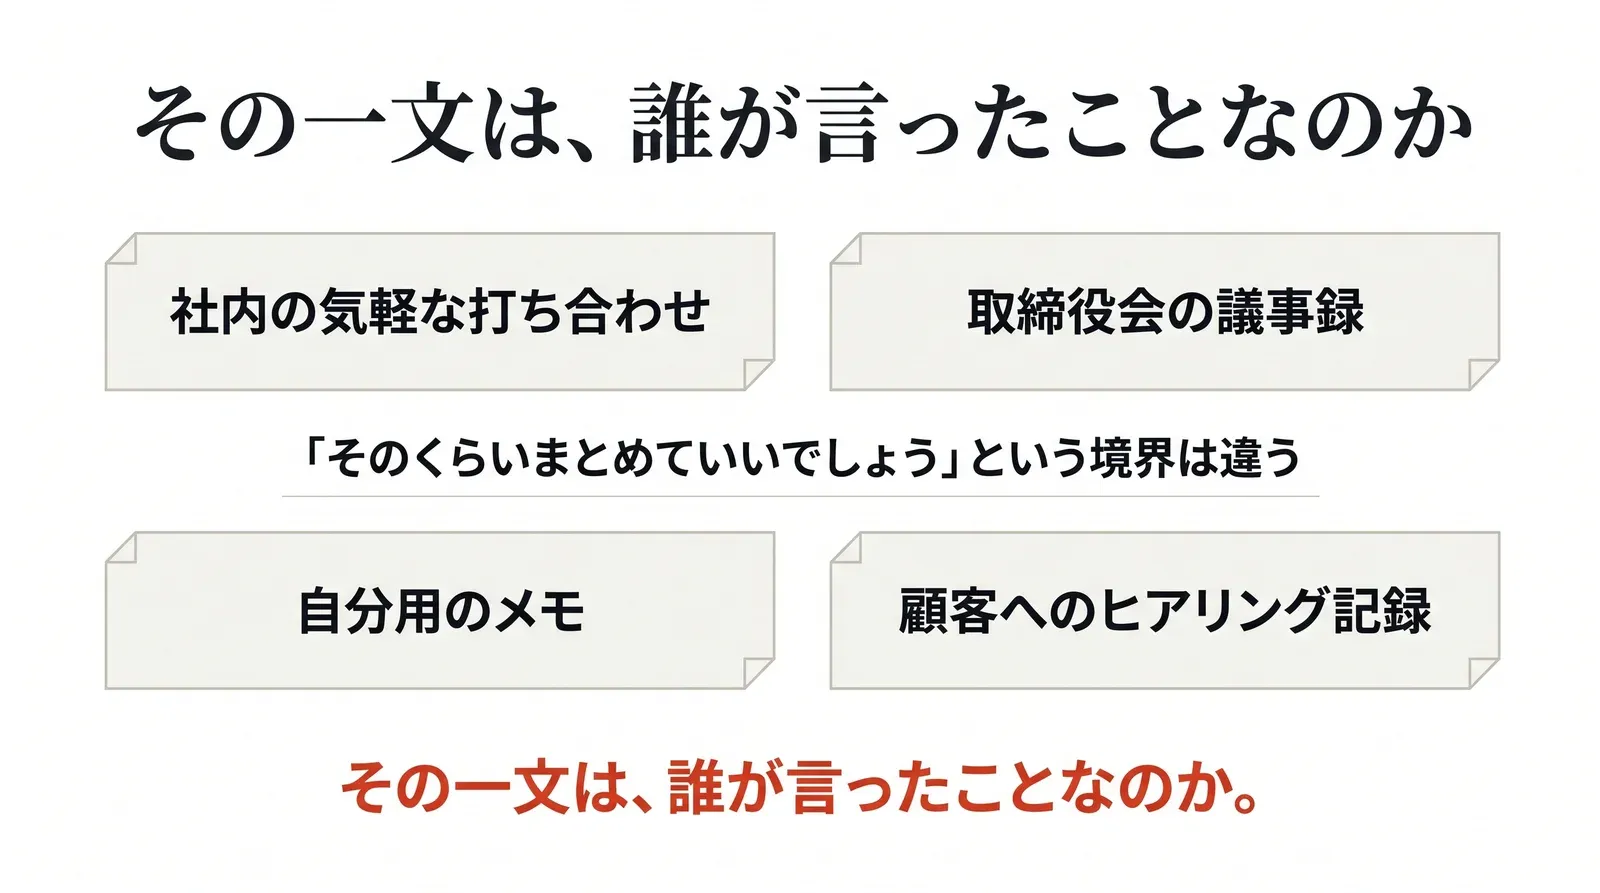
社内の気軽な打ち合わせと、取締役会の議事録では違うだろう。
自分用のメモと、顧客へのヒアリング記録でも違う。
人によっても、「そのくらいまとめていいでしょう」という境界は違うと思う。
私の場合は、昔の仕事で身についた感覚もあって、自分が文責を持つ文章では、この境界がかなり気になる。
でも、それも一つの感覚にすぎない。
AIによって、議事録を作る時間は劇的に短くなった。これは間違いなく便利だ。
ただ、私たちが「無駄な作業」としてAIに渡したものの中には、会議で交わされた言葉から、組織として何を残すのかを選ぶ仕事も含まれていたのではないか。
昔から議事録は、発言をそのまま保存するものではなかった。誰かが拾い、捨て、圧縮し、並べ替えていた。
そこには確かに、意味編集の工程があった。
AIは、その工程を驚くほど速くやってくれる。
だからこそ最近、AIが作った議事録を読むと、ときどき立ち止まる。
その一文は、誰が言ったことなのか。
発言者が言ったことなのか。
議事録を作った人が解釈したことなのか。
それとも、AIが二つの間を自然につないで作った意味なのか。
どこまで区別する必要があるのかは、議事録の目的によって違うのだと思う。
それでも、議事録作成という仕事をAIに渡したとき、私たちは単に「文章を書く作業」だけを渡したのだろうか。
意味編集の工程まで渡したのだとしたら、その文責はどこに残るのだろう。
まだ、少し気になっている。