· 技術革新とデジタルトレンド · シリーズ: テクノロジーの現在地 · 読了目安 9 分
AIは何でも書いてくれる。だから、何を書かないかが重要になった
生成AIを使うようになってから、文章を書くこと自体はずいぶん簡単になった。
あるテーマについて記事を書こうとすれば、概要を説明し、前提条件を整理し、使い方を紹介し、注意点を挙げ、最後にまとめまで付けてくれる。足りない項目があれば補ってくれるし、「初心者向けに詳しく」と頼めば、さらに丁寧な説明にもしてくれる。
だから最近は、ネット上で「ちゃんとした記事」を見かけることが本当に増えたように思う。
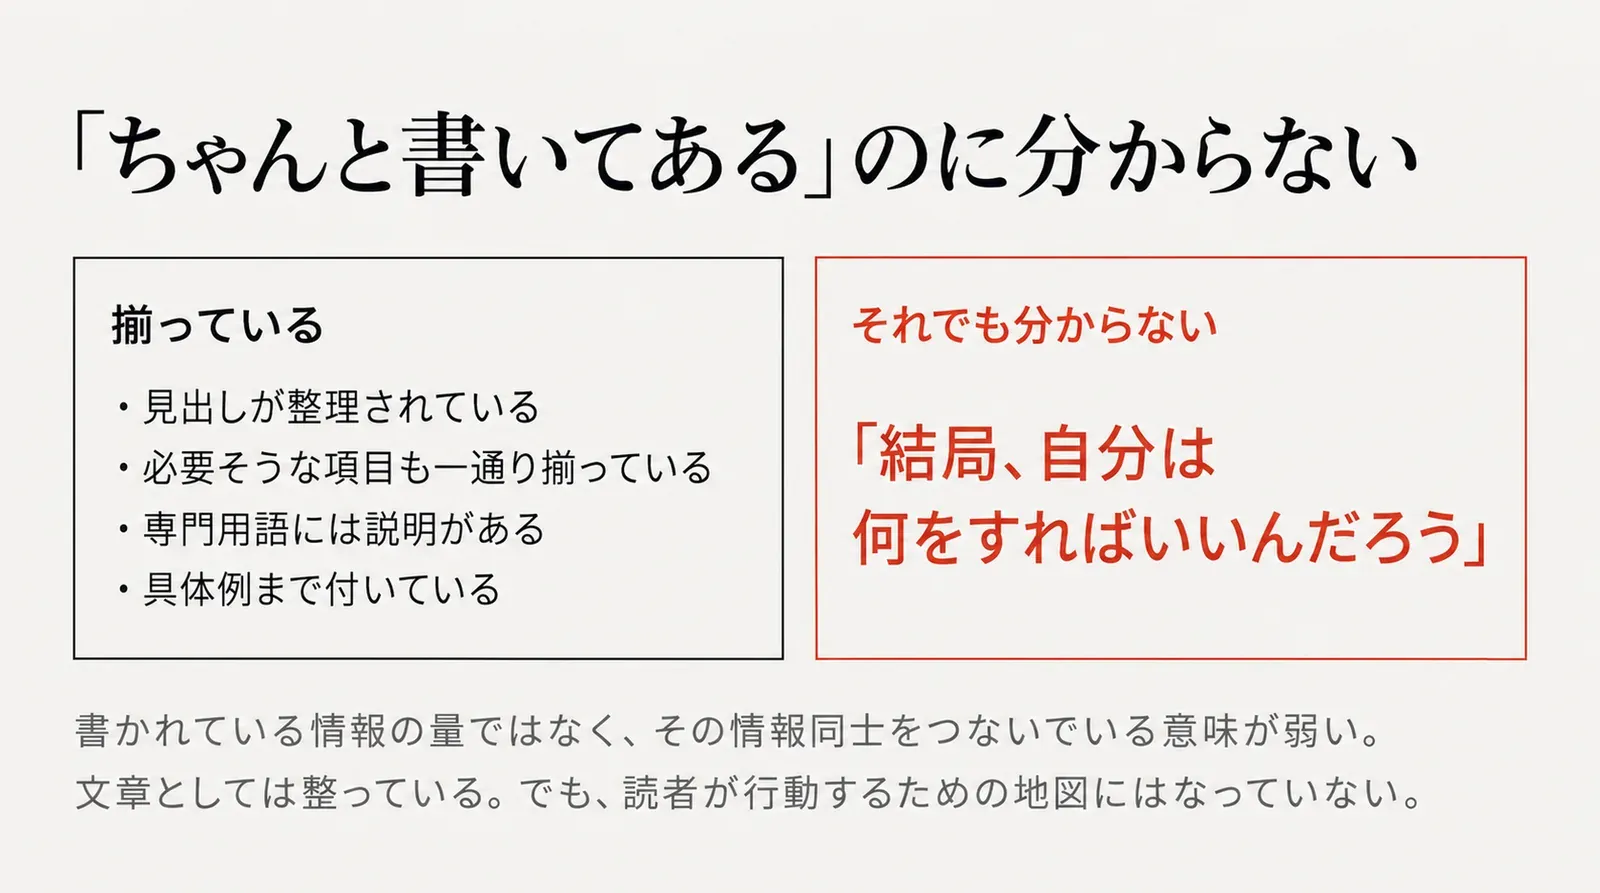
見出しが整理されている。必要そうな項目も一通り揃っている。専門用語には説明があり、具体例まで付いている。
それなのに、ときどき妙なことがある。
一通り読んだはずなのに、「結局、自分は何をすればいいんだろう」と分からない。
情報が足りないわけではない。むしろ、たくさん書いてある。
それでも分からない。
以前なら、こういう文章を単純に「説明が下手なのだろう」と思っていたかもしれない。
最近は、少し違う見方をするようになった。
書かれている情報の量ではなく、その情報同士をつないでいる意味が弱いのではないか。
誰が何をするのか。
なぜそれが必要なのか。
どのタイミングで必要になるのか。
初心者が最初にやることと、使い込んでから必要になることは何が違うのか。
そうした関係が十分に整理されないまま、関連する情報だけがきれいに並んでいる。
文章としては整っている。でも、読者が行動するための地図にはなっていない。
このことを考えていて、私は自分がClaude Codeを使い始めた頃のことを思い出した。
「ちゃんと書いてある」のに分からない
Claude Codeが出始めた頃、私も使ってみようと思って、いろいろな解説記事を読んだ。
そこには、
「CLAUDE.mdを置きましょう」
「skillsフォルダを作りましょう」
「SKILL.mdには目的や呼び出し条件を書きます」
「ディレクトリはこのような構造にします」
といった説明が並んでいた。
どれも、おそらく技術的には間違っていない。
ところが、まだClaude Codeを使ったことがなかった私には、それが参入障壁になった。
「Claude Codeを使うためには、まずこういうフォルダを作らないといけないんだ」
「CLAUDE.mdというファイルを自分で準備しないといけないらしい」
「SKILL.mdには決められた構造があるらしい」
そう考えているうちに、なかなか使い始められなかった。
実際に使うようになってから、見え方はかなり変わった。
最初から完璧なディレクトリ構造を設計する必要などなかった。
まずClaude Codeを立ち上げて、
「このディレクトリでは、こういう仕事をしてほしい」
「ここまでは変更していい」
「ここから先は確認してほしい」
と伝えて仕事を始めればいい。
繰り返し使いたいものが出てきたら、その段階で永続化すればいい。Skillとして切り出したくなったら、そのとき構造を考えればいい。
もちろん、公式仕様を正確に知りたいなら公式ドキュメントを読めばよい。
でも、使い始めるために必要だった情報は、公式仕様の網羅的な解説とは少し違っていた。
網羅性のインフレ
ここで、ひとつ気になることがある。
生成AIによって、「網羅的な文章」を作るコストがほとんどなくなった。
以前なら、
概要、前提条件、設定方法、ディレクトリ構成、具体例、注意事項、FAQ、トラブルシューティング、まとめ。
これだけ揃った解説記事を書くには、かなりの手間が必要だった。
調査し、整理し、書き、足りないところを調べ直す。
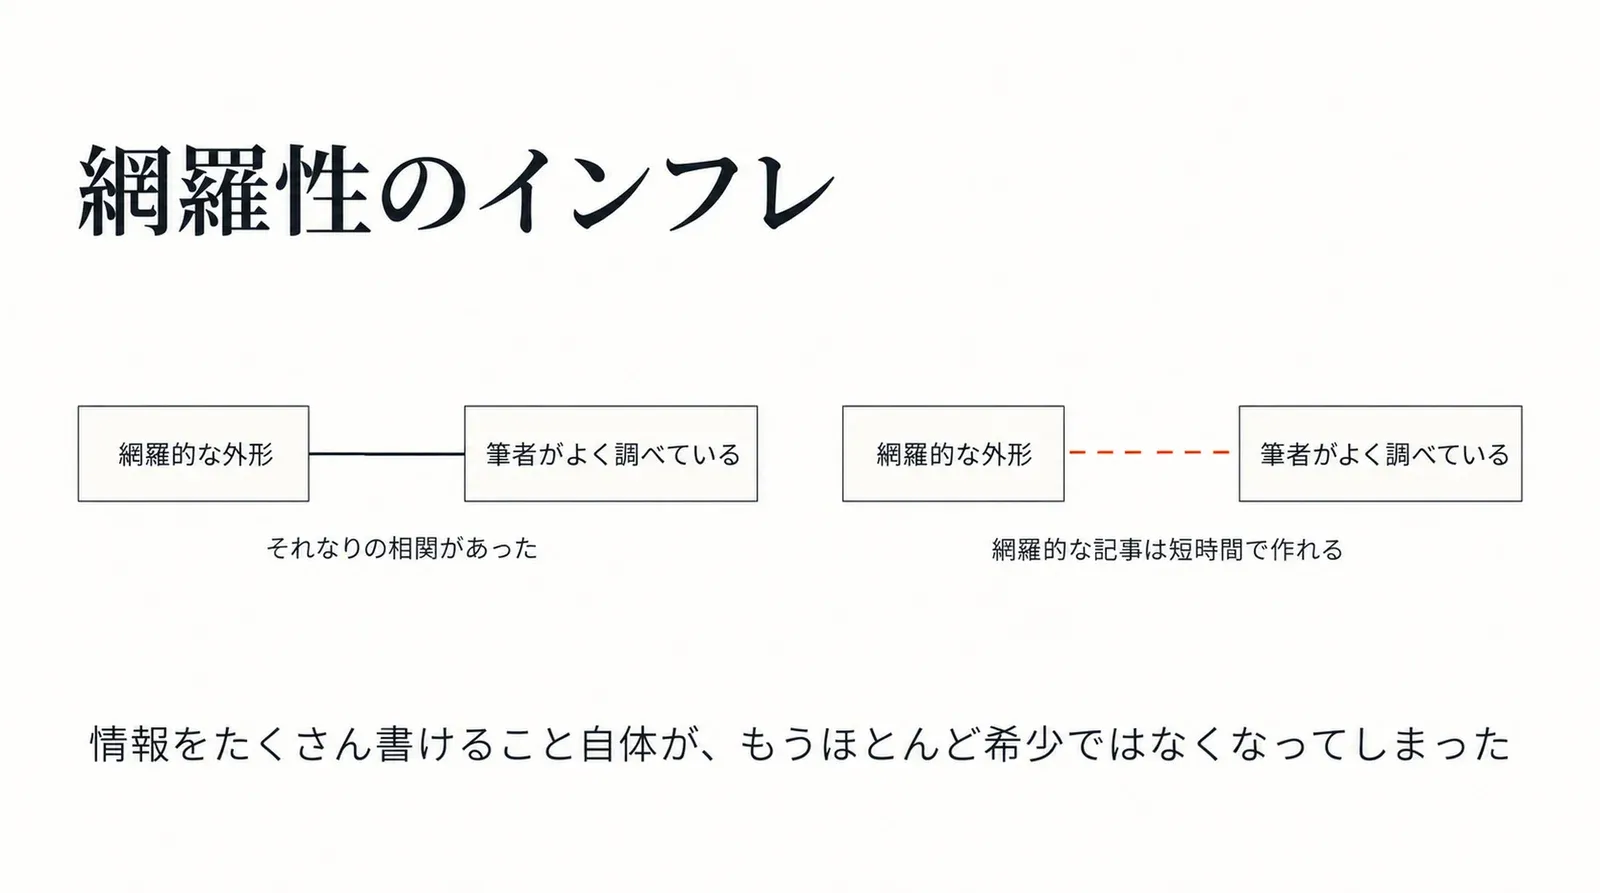
だから、「情報が網羅されている」という外形と、「筆者がよく調べている」という事実には、それなりの相関があったのだと思う。
生成AIは、その相関をかなり壊した。
公式ドキュメントといくつかの記事を材料として渡せば、それらしい網羅的な記事は短時間で作れる。
しかも文章は整っている。
見出しもある。
注意事項もある。
初心者向けの説明まで付いている。
結果として、ネット上には「ちゃんとした解説記事の形」をした文章が急速に増えていく。
私はこれを、少し大げさに言えば「網羅性のインフレ」と呼んでもいいのではないかと思っている。
情報をたくさん書けること自体が、もうほとんど希少ではなくなってしまった。
二種類の「省略」
ところが、ここで妙なことが起きる。
網羅的な記事が当たり前になるほど、情報を省いた文章は「足りない文章」に見えるようになる。
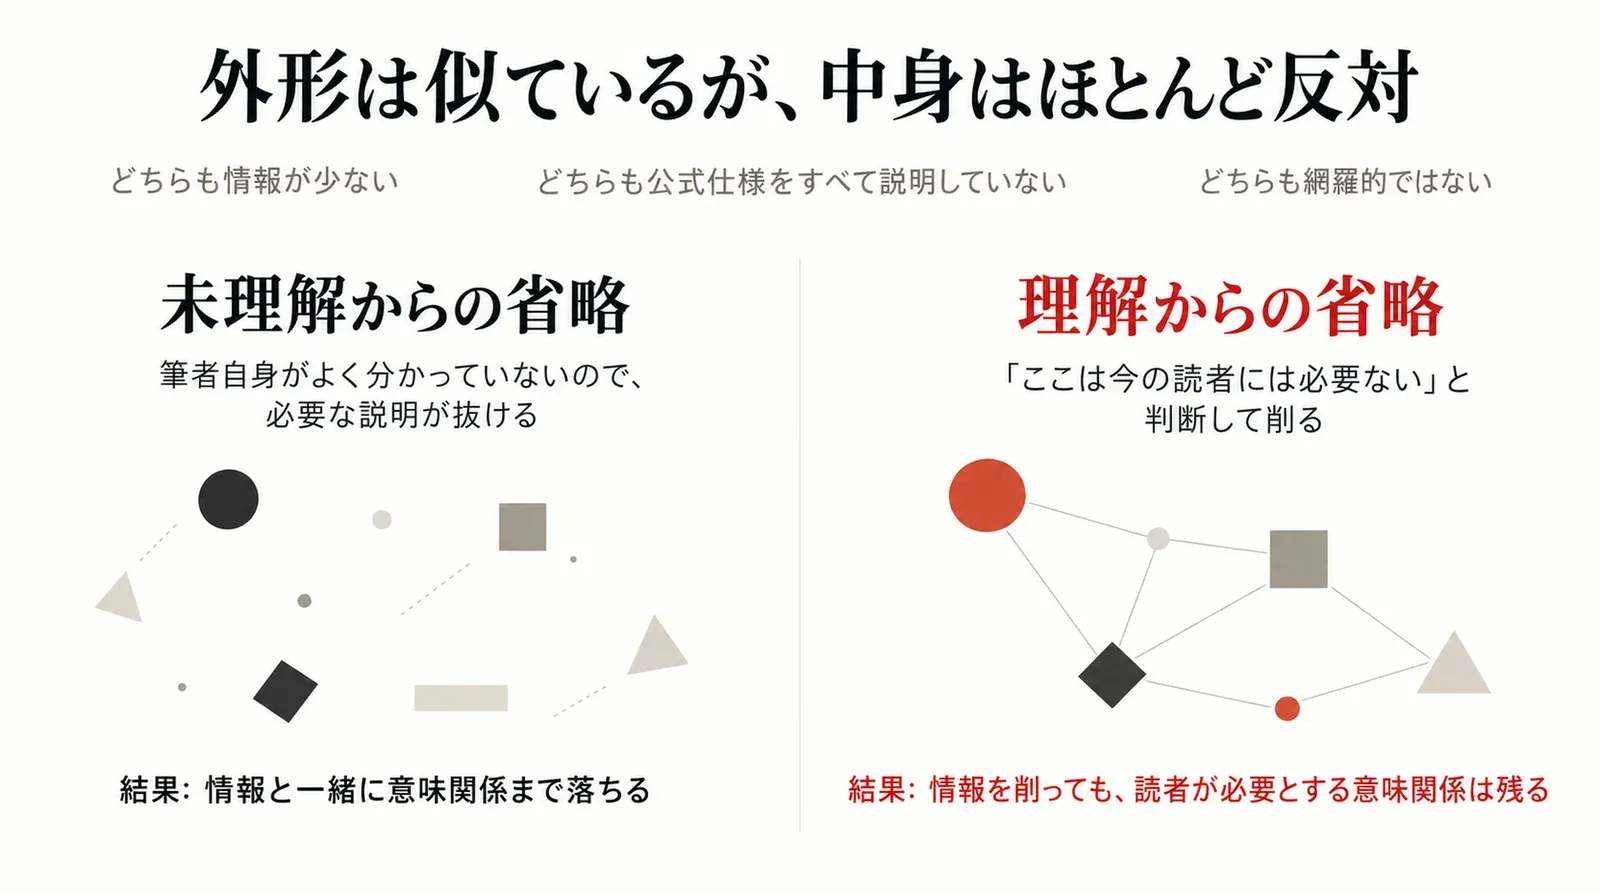
でも、省略には少なくとも二種類ある。
ひとつは、未理解からの省略。
筆者自身がよく分かっていないので、必要な説明が抜ける。
誰が何をするのか。
なぜそれが必要なのか。
どこまでが利用者の操作で、どこからがシステム内部の処理なのか。
そこが書かれていない。
結果として、読者は欠けた意味を自分で補わなければならなくなる。
もうひとつは、理解からの省略。
十分に理解しているからこそ、
「ここは今の読者には必要ない」
「詳細な仕様は公式ドキュメントを見ればいい」
「ここを説明すると、かえって最初の一歩が分かりにくくなる」
と判断して削る。
外形だけを見ると、この二つはよく似ている。
どちらも情報が少ない。
どちらも公式仕様をすべて説明していない。
どちらも網羅的ではない。
しかし、中身はほとんど反対である。
未理解からの省略では、情報と一緒に意味関係まで落ちる。
理解からの省略では、情報を削っても、読者が必要とする意味関係は残る。
むしろ余計な説明を消したことで、何をすればいいのかが分かりやすくなることもある。
「全部書いていない」は、本当に欠点なのか
少し怖いのは、私自身も「情報が揃っている文章の方がちゃんとしている」と感じる傾向を持っていることだ。
設定項目がすべて載っている。
例がたくさんある。
関連機能も解説されている。
注意事項も網羅されている。
そういう記事を見ると、「よく調べてある」と感じる。
逆に、
詳細な仕様は公式ドキュメントを見てください。ここでは、実際に使ってみて私が一番つまずいたところだけ書きます。
と始まる記事は、一見すると情報不足に見えるかもしれない。
しかし、その人が本当に何十回も使った結果、
「初心者が知るべきなのはここだ」
と判断しているのであれば、こちらの方がはるかに価値があることもある。
Googleの検索コンテンツ向けガイドを見ても、この問題は単純ではない。
Googleは自己評価の項目として、トピックについて十分で包括的な説明があるかを挙げている。一方で、独自の情報や分析があるか、他の情報源を書き換えただけになっていないか、実際に使った経験や深い知識が示されているかも重視している。生成AIについても、ユーザーへの付加価値なしに大量生成することは推奨していない。
つまり、「長く網羅的に書けば検索エンジンに評価される」と単純に言えるわけではない。
それでも、網羅性は外から確認しやすい。
ある項目が「書いてあるか、書いていないか」は機械でも人間でも比較しやすい。
一方、
「この筆者は十分理解したうえで、ここをあえて削った」
という編集判断を外から評価するのは難しい。
そこに、少し不均衡があるように思う。
AIが増やしたのは、情報だけではない
生成AIによってネット上の情報量が爆発的に増える、とよく言われる。
確かにそうなると思う。
でも増えるのは文章の本数だけではない。
ひとつの記事の中に含まれる情報量も増える。
頼めば説明を足してくれる。
例を増やしてくれる。
注意事項を追加してくれる。
関連項目を補ってくれる。
FAQも作ってくれる。
AIは、「不足しているように見える場所」を埋めることがとても得意だ。
その結果、どの記事にも似たような説明が入り、似たような見出しが並び、似たような注意事項が付く。
ネット全体で見れば、同じ情報が少しずつ書き換えられながら、ものすごい勢いで複製されていく。
これも「網羅性のインフレ」の一部なのだと思う。
これから希少になるもの
情報をたくさん書けることは、もう希少ではない。
むしろこれから希少になるのは、
何を書かなくていいかを判断できること
ではないだろうか。
何を削ったら意味が壊れるのか。
何なら公式情報に任せてよいのか。
読者が今必要としているものは何なのか。
自分だから付け加えられる経験はどこにあるのか。
どこから先は、自分が語る必要のない話なのか。
こうした判断には、そのテーマについての理解が必要になる。
そしておそらく、これが編集という仕事のかなり本質的な部分なのだと思う。
AI以前は、「書くこと」そのものにコストがあった。
だから編集は、書かれた文章を整える仕事として見えやすかった。
AIが何でも書いてくれるようになると、その順番が変わる。
いくらでも足せる。
いくらでも説明できる。
いくらでも「ちゃんとした記事」にできる。
だからこそ最後に問われるのは、
この文章には、本当に何が必要なのか。
という判断になる。
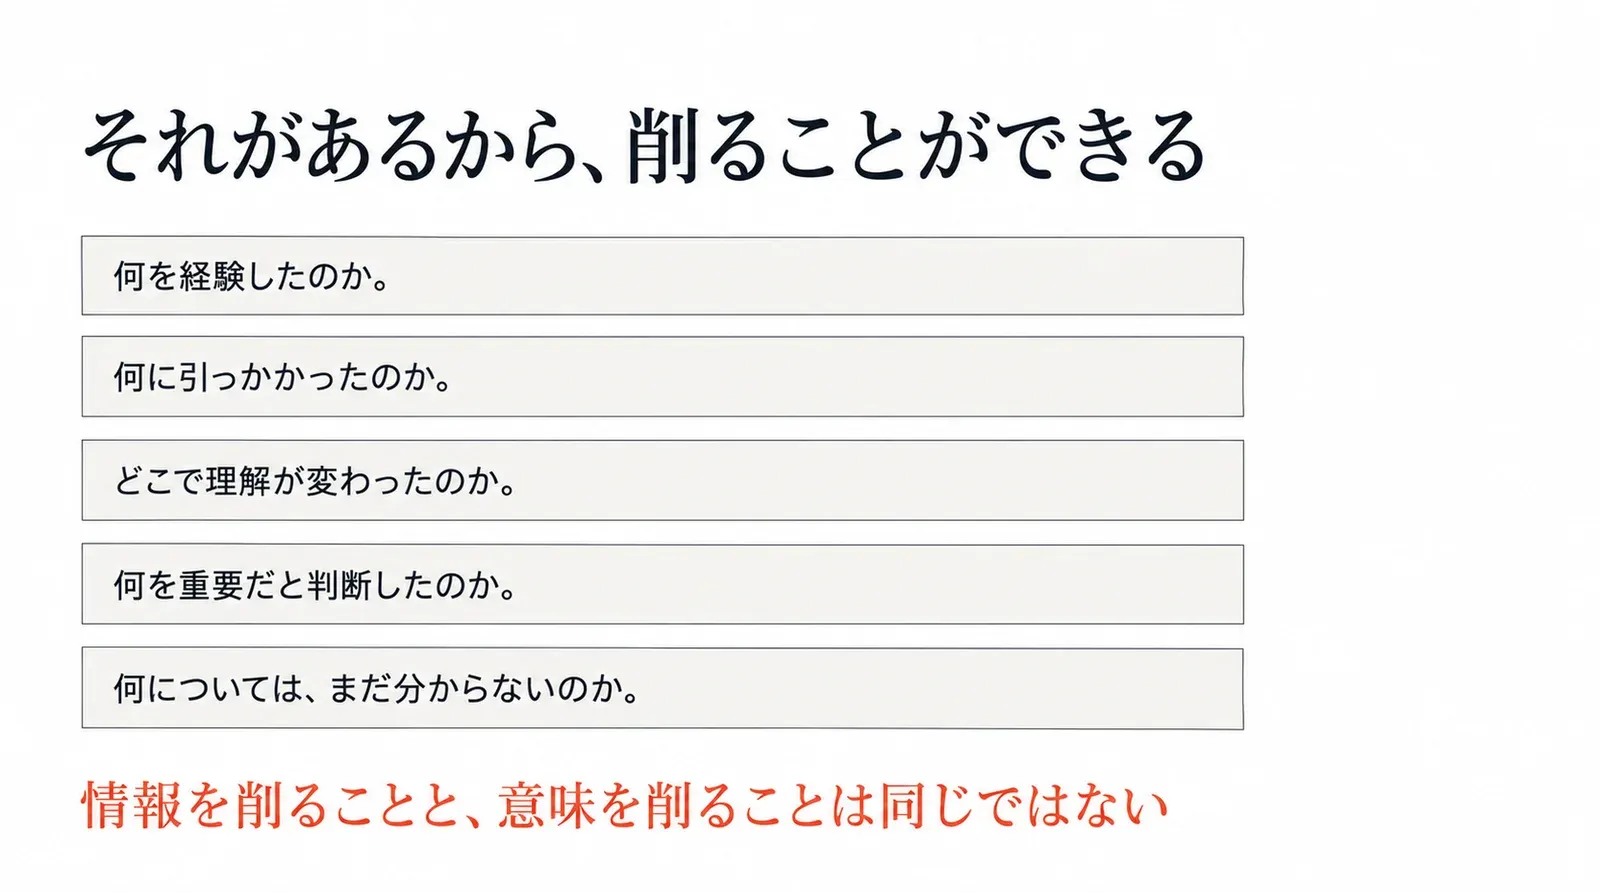
そして、その判断をするためには、筆者自身の意味空間が必要になる。
何を経験したのか。
何に引っかかったのか。
どこで理解が変わったのか。
何を重要だと判断したのか。
何については、まだ分からないのか。
それがあるから、削ることができる。
情報を削ることと、意味を削ることは同じではない。
理解した人がする省略は、ときに文章を貧しくするどころか、意味を濃くする。
AIが何でも書いてくれる時代になった。
だから私は、以前よりも「何を書くか」ではなく、「何を書かないか」を考える時間が増えていくのではないかと思っている。